复现 Hacker News 写作风格指纹识别
原文由 Salvatore Sanfilippo 于 发布,订阅该博客
大约三年前,我在 Hacker News 上看到一篇相当新奇有趣的帖子。一名叫 Christopher Tarry 的学生能够对评论中高频词的词频向量计算余弦相似度,以此来找出相似的 HN 账号——有时甚至能发现实际上由同一人控制的多个账号,也就是用来掩盖作者真实身份的马甲账号。
原帖地址如下:https://news.ycombinator.com/item?id=33755016
当时我还不知道 Burrows-Delta 这种风格检测方法:只需要对高频词的词频向量做归一化就能取得如此出色的效果,这在我看来简直有点神奇。我看了几篇维基百科的介绍,算是记在了心里。后来在为 Redis 开发向量功能时,我又想起了这篇帖子,上网搜索后才发现原页面已经无法访问,而且作者在原帖和网站上其实并没有很好地解释数据是如何处理的、高频词是如何提取的(尤其是究竟用了多少词)等等。我想,等主要工作完成后,或许可以用 Vector Set 来复现这项工作。现在这个新数据类型已经进入发布候选阶段,我也终于抽出时间来研究这个问题。下面就是我的实践报告,不过在继续之前,先放上必备的演示站点,你可以在下面的链接中试玩:
https://antirez.com/hnstyle?username=pg&threshold=20&action=search
说明:由于数据集需要占用 700MB 内存,在我这台小服务器上,未来几个月我可能会将其下线。不过,在本文后面你会找到相关链接和 GitHub 仓库,其中包含了从零开始复现全部流程的代码。
说明 2:希望这个网站能撑住,它只是一个非常简陋的 Python 脚本。我在这台小服务器上测试了 VSIM 命令,即便如此它每秒仍能处理 8 万次 VSIM!这多亏了 int8 量化以及另外一些优化。不过 Python 脚本写得很糟糕,每次都会新建一个 Redis 连接等等。只能祈祷它别挂了。
原始数据的下载与处理
要做类似的事情,我遇到的第一个问题就是去哪里找 Hacker News 评论的存档。幸运的是,我找到了一份据称包含了从 Hacker News 创站到 2023 年所有帖子的数据集,总大小高达 10GB。你可以在这里找到它:https://huggingface.co/datasets/OpenPipe/hacker-news,说实话,我也不太确定它是怎么来的,是通过爬取得到的,还是 HN 以某种方式公开了这些数据。
至少对于公开数据集而言,我不太喜欢二进制文件,所以我用了两个 Python 脚本来把 Parquet 文件转换成更小、更易于处理的形式。第一个脚本 gen-top-words.py 会读取这些二进制文件,并生成一个包含数据集中最常用 N 个词列表的 txt 文件。默认会生成 1 万个词,但做统计分析其实需要少得多(或者说,实际上:如果你用的词太多,捕捉到的就不再是写作风格,而是用户在谈论什么内容了!)。然后,另一个 Python 脚本会汇总每个用户的所有评论,并生成一个非常大的 JSONL 文件,其中只有两个键:用户名和该用户在 Hacker News 从创站到 2023 年全部历史评论中所用词汇的词频表。每一条记录就像这样:
{"by": "rtghrhtr", "freqtab": {"everyone": 1, "hates": 1, "nvidia": 1, "but": 1, "treats": 1, "ati": 1, "as": 1, "an": 1, "afterthought": 1, "another": 1, "completely": 1, "useless": 1, "tool": 1, "to": 1, "throw": 1, "on": 1, "the": 1, "pile": 1}}到这一步,最后一个脚本 insert.py 就可以完成真正的工作了:为每个用户应用 Burrows 方法,生成用户的风格向量,并插入到 Redis 中。预先处理这些文件(这是一个很慢的过程)的好处是,插入脚本可以用不同的参数(尤其是要使用的高频词数量)更方便地反复调用,从而更快地看到不同参数下的结果,而无需每次都重新处理 Parquet 文件。
Burrows 方法是如何工作的?
在原帖中,Christopher 写道只需对词频做归一化并计算余弦相似度即可。实际上过程要稍微复杂一些。首先,我们来想想,这个方法本质上是如何运作的?它想要捕捉的是每个特定用户相对于预期的“平均”语言,对某些词过度使用或使用不足的情况。为此,我们实际上采用了以下步骤(来自 Python 代码)。
这就是我们对每一个高频词所做的处理:
# Convert to relative frequency
rel_freq = frequency / total_words

# Standardize using z-score: z = (freq - mean) / stddev
mean = word_means.get(word, 0.0)
stddev = word_stddevs.get(word, 1.0)  # Default to 1.0 to avoid division by zero

z_score = (rel_freq - mean) / stddev

# Set the z-score directly in the vector at the word's index
vector[word_to_index[word]] = z_score
我们首先通过减去该词的*全局*使用频率,来对用户使用某个词的频率进行“中心化”。这样,我们就得到了一个数值,用来描述该用户对这个词是使用不足(负值)还是过度使用(正值)。但是,仔细想想,那些在不同作者之间使用方差本身就很大的词,即使发生了变化,其重要性也相对较低。我们希望放大那些与该词正常方差相比,被该用户异常地过度或不足使用的词所带来的信号。这就是为什么我们要将中心化后的频率除以该词的全局标准差。现在我们就得到了所谓的“z 分数”,它是一个经过调整的度量,用来衡量某个词在某个方向上偏离常态的程度。
现在,我们就可以用下面这条命令把词向量插入到 Redis 的 vector set 中了:
VADD key FP32 [blob with 350 floats] username(我在这里不会详细介绍 vector set 的细节,你可以在这里找到文档 -> https://github.com/redis/redis/blob/unstable/modules/vector-sets/README.md)
注意,Redis 会对插入的向量进行 L2 归一化,但会记住 L2 的值,以便在使用 VEMB 取回关联向量时还原原始数值,因此 z_score 就是按原样设置的。
最后,通过 VSIM,我们就可以找到相似的用户:
127.0.0.1:6379> vsim hn_fingerprint ele pg
 1) "pg"
 2) "karaterobot"
 3) "Natsu"
 4) "mattmaroon"
 5) "chc"
 6) "montrose"
 7) "jfengel"
 8) "emodendroket"
 9) "vintermann"
10) "c3534l"所有代码(除了网站本身)都可以在这里找到:https://github.com/antirez/hnstyle
README 文件中说明了如何复现每一个环节。
为什么是 350 个词?
促使我写这篇博客的原帖中缺失的一点,就是究竟该使用多少个高频词。如果你使用的词太多,就会看到很多我关于 Redis 的评论,因为 Redis 本身就是最常用的前 1 万个词之一。猜猜怎么着?我一开始就恰好犯了这个错误,结果 VSIM 一直返回的是那些谈论话题与我相似的用户,而不是写作*风格*相似的用户。不过幸运的是,互联网档案馆缓存了 Christopher 针对“pg”这个账号的结果,就在这里:
https://web.archive.org/web/20221126235433/https://stylometry.net/user?username=pg
这样我就可以调整 top-k 的取值来获得相似的结果。此外,通过阅读原始论文,我惊讶地发现,要让分析有效,甚至只需要 150 个词就够了。一般来说,150 到 500 这个区间被认为是最佳范围。
提醒一下:别以为搜索某个用户时找到的大多是马甲账号。对于许多马甲账号来说,数据量太少,因为人们常常会创建一次性账号,只发几条评论就不再使用了。所以,与给定用户风格相关联的大多数账号,其实只是写作风格相似的其他人。我认为这个方法在区分谁是母语者、谁不是母语者方面相当有效,这一点从下面的向量可视化中尤为明显。
验证与可视化……
我复现的另一点(同样来自原帖作者的想法)是尝试将同一个用户用两组不同的评论插入两次,例如 antirez_A 和 antirez_B,然后检查在查询与 antirez_A 相似的用户时是否会返回 B。事实上,对于我测试的大多数用户来说,这个方法效果非常好,而且很多时候对方就是排名第一的结果。所以我们知道,这个方法确实是有效的。
但既然从向量中如此容易就能“看出”一种风格,那用肉眼又如何呢?最近我换成了 Ghostty 作为终端,它支持 Kitty 图形协议,因此可以直接在终端窗口中显示位图。我早就想试试这个功能了。终于有了一个合适的理由来测试它。
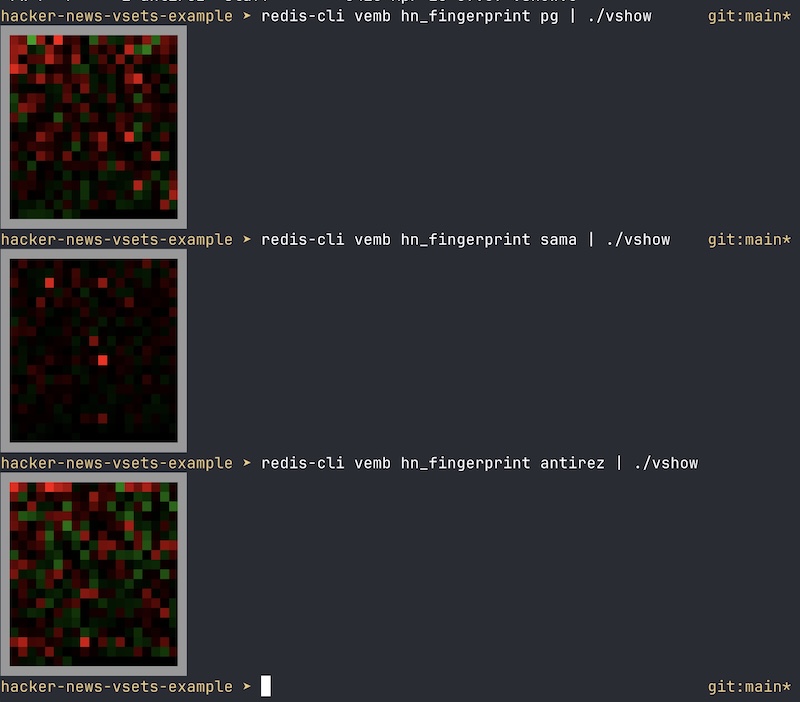
上图展示的是我们调用 VEMB 命令,它只会返回一串浮点数(即向量)。然后,同样包含在仓库中的 vshow 工具会负责找到能容纳该向量的最小正方形,并将正值显示为红色,负值显示为绿色。
如你所见,作为非母语者,我过度使用一些非常简单的词,而对更复杂的词则使用不足。其他作者则会在某些特定词上表现突出,还有一些则要“平淡”得多,显示出的特征也更少。有一段时间我很好奇那里到底发生了什么:我究竟过度使用了哪些词,又有哪些词用得太少?所以在演示网站上,你还可以点击按钮来分析某个用户,查看其过度使用和欠缺使用最多的前 10 个词。好吧,其中有几个确实是因为我的英语语法问题 :D
好了,这次探索就到这里!Vector Set 现在已经进入 Redis 8 RC1,我还有更多工作要做,但这次尝试很有趣,我觉得它表明向量在 AI 出现之前就已经很酷了。感谢你读完这么长的一篇文章。
补充:我忘了说,insert.py 脚本还会插入包含用户总词数的 JSON 元数据。所以你可以使用 FILTER 来只显示符合特定词数条件的匹配结果。这对于检测重复账号很有用,因为这类账号往往只在需要掩盖身份时才会偶尔使用:
127.0.0.1:6379> vsim hn_fingerprint ele pg FILTER ".wordcount < 10000"
 1) "montrose"
 2) "kar5pt"
 3) "ryusage"
 4) "corwinstephen"
 5) "ElfinTrousers"
 6) "beaned"
 7) "MichaelDickens"
 8) "bananaface"
 9) "area51org"
10) "william42"
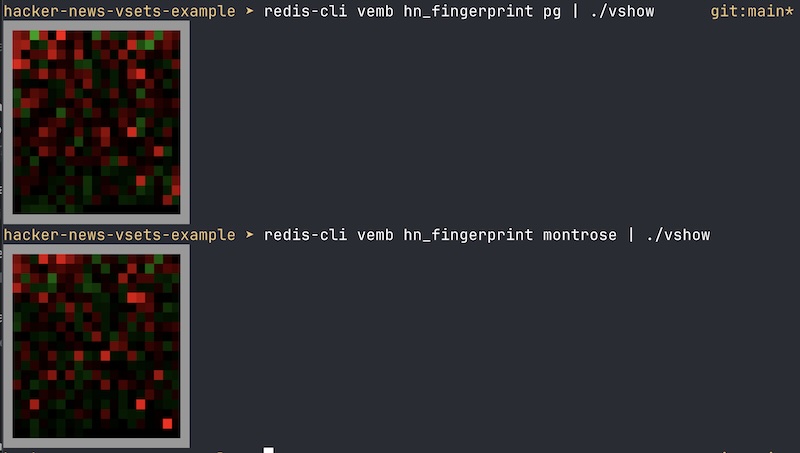
补充 2:如果匹配结果在你看来很可疑(毫无意义),就像 tptacek 在这篇博客的 HN 投稿评论中所指出的那样,这里有一个“可视化”的匹配示例,展示了例如 montrose 和 pg 在词语使用模式上是多么相似:
评论
登录后参与讨论