字形簇与终端模拟器
原文由 Mitchell Hashimoto 于 发布,订阅该博客
在终端模拟器中复制粘贴“🧑🌾”,光标会向前移动多少个单元格?取决于你使用的终端模拟器,可能会移动 2、4、5 或 6 个单元格1。吓人吧。本文将解释这背后的原因,以及终端模拟器和程序作者如何为所有字符实现一致的间距。
字符网格的历史
终端运行在一张由固定大小单元格组成的网格上。这是终端模拟器工作的基础,因为程序发送给终端的许多控制序列都是以单元格为单位进行操作的。
例如,有用于将光标向左CSI n D、向右CSI n C、向上CSI n A或向下CSI n B移动的控制序列。其中每个序列的“n”都是要移动的单元格数量。还有一个请求光标位置的序列CSI 6 n。终端会以CSI y ; x R的形式向程序返回,其中“y”和“x”都是单元格坐标。
传统上,终端只是读取输入的字节流,并将每个字节逐一映射到网格中的一个单元格。例如,字符串“1234”有 4 个字节,程序员可以非常轻松地一次读取一个字节,将其放入下一个单元格,光标右移一格,如此重复。
后来,出现了“宽字符”。常见的宽字符有亚洲字符如 橋 或表情符号如 😃。libc 中新增了一个函数wcwidth,用于返回宽字符以单元格计的宽度。宽字符的宽度通常被设为“2”。因此,如果你在终端模拟器中输入 橋,这个字符会占据两个网格单元格,光标也应该向前跳动两个单元格。
而这也是如今大多数终端模拟器和终端程序(Shell、TUI 等)的实现方式:它们通过wcwidth处理输入字符并相应地移动光标。曾几何时,这种方式完全够用。但如今,这已经不再足够,并会导致许多错误。
字形簇化
事实证明,单个 32 位值并不足以表示世界上每一个用户感知的字符。“用户感知的字符”正是 Unicode 标准对字形簇的定义。
以表情符号“🧑🌾”为例。如果你的电脑不支持,它看起来应该像这样。我想所有人都会认同这是一个“用户感知的字符”,也就是一个字形簇。Unicode 标准本身就将其定义为单个字形簇,所以无论你个人怎么看,国际标准都认定这是一个字形簇。

但对计算机来说就没那么直观了。“🧑🌾”由三个码点组成(U+1F9D1 🧑、U+200D 和 U+1F33E 🌾),在 UTF-32 编码下是三个 32 位值,在 UTF-8 编码下则是 11 个字节2。
如果像过去那样只考虑 32 位值,并将每个码点单独传给wcwidth,我们会依次得到“2”、“0”、“2”的结果。因此,光标会向前移动 4 个单元格。这就是为什么在大多数终端中(截至本文撰写时),你会看到光标向前移动了 4 格
那个零宽字符是怎么回事?码点U+200D被称为零宽连接符(ZWJ),其标准定义的宽度为零。ZWJ 会告诉文本处理系统将其前后的码点连接成一个字符。这就是为什么你可以输入“🧑🌾”和“🧑🌾”两者,带引号的这两个值之间唯一的区别在于,左边的农民表情在两个表情符号之间有一个零宽连接符。
于是就有了字形簇化。字形簇化是指从一串码点中确定单个字形簇的过程。正是这个过程让程序能够将三个 32 位值视为一个用户感知的字符。字形簇化的算法定义在UAX #29《Unicode 文本分割》中。这里不详述算法的工作原理,任何现代编程语言的 Unicode 库都应该能够执行字形簇化。
字形簇化的一大挑战在于它是有状态的。你必须同时拥有前一个码点、当前码点以及一个整数状态值,才能可靠地确定字形簇的边界。因此,要把它集成到现有程序中并不算特别容易(但也不难)。
有了字形簇化,终端会将“🧑🌾”视为单个宽字符字形簇,光标只会向前移动两个单元格,而不是四个。
这可不仅仅关乎表情符号。我只是拿表情符号举例,但字形簇化对于正确处理世界上的各种语言也极为重要。例如,阿拉伯文字常常由多个码点组成。
题外话:字体塑形。字形簇化只解决了在码点流中确定字形簇边界的问题,并没有解决渲染码点流的问题。要做到这一点,你需要一个字体塑形引擎,例如Harfbuzz。Harfbuzz 会读取一串码点,识别其中的字形簇,然后将这些字形簇映射到字体中的各个字形。
本文不会涉及字体塑形,但如果你在终端中粘贴“🧑🌾”却看到两个表情符号而不是一个,那要么是因为终端去掉了零宽连接符,更可能是因为终端不支持字体塑形。
终端中的字形簇化
如今大多数终端都不支持字形簇化。一个重要原因是,像 Shell 和文本编辑器这样的高级终端应用常常需要时刻精确知道光标的位置,并与终端的网格状态保持同步。
由于历史上终端使用wcwidth,Shell、编辑器和其他 TUI 应用也都使用wcwidth,并且至今仍在沿用。尽管它对多码点字形簇会产生错误的值,但至少这种错误的值在不同终端模拟器之间往往是一致地错。
当我最初为我的终端实现文本处理时,我加入了完整的字形簇支持,因为我以为这会是一件好事。然而,我很快就失望地发现,当我做了正确的字形簇化后,fish shell 在我移动光标时会把提示符重绘到错误的位置。😞 我的 Shell 假定终端使用wcwidth,而我的终端则假定程序不在乎。我们都错了,所以我只好禁用了字形簇化……
于是有了模式 2027。模式 2027 是一项为终端提供字形簇支持的提案。该提案来自Contour 终端的作者。其思路是,运行在终端中的程序可以通知终端,它希望以完全支持字形簇化的方式运行,并且该功能可以开启和关闭。运行中的程序还可以查询终端是否支持此功能。
我最近在我的终端中实现了对模式 2027 的支持,下面可以看到其效果。关闭模式 2027 时,光标在农民表情之后会移动到第 5 列(宽度为 4)。开启模式 2027 时,光标则会移动到第 3 列(宽度为 2)。
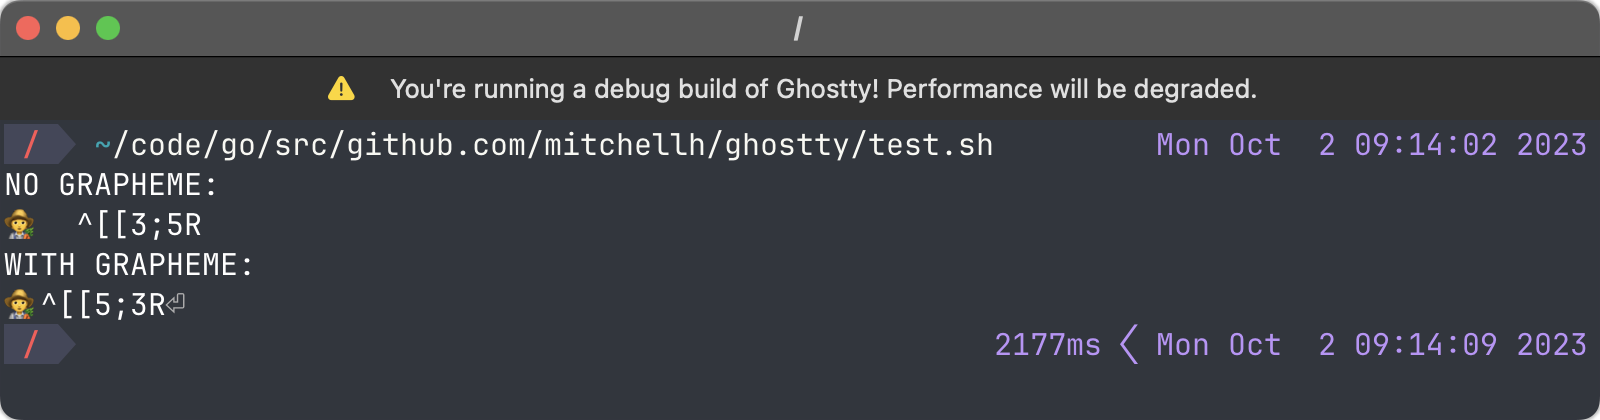
终端对比
下表展示了各终端对“🧑🌾”报告的宽度。对于每个终端,我都使用了截至 2023 年 10 月 2 日能找到的最新版本。我把自己的终端排在最前面,其余按字母顺序排列。
| 终端 | 宽度 | 模式 2027 | 备注 |
|---|---|---|---|
| Ghostty | 2 | ✅ | 如果禁用模式 2027,则回退到wcwidth |
| Alacritty | 4 | ❌ | 不支持塑形,显示为两个独立的表情符号 |
| Contour | 2 | ✅ | 发明了模式 2027,始终执行字形簇化 |
| Foot | 2 | ✅ | 如果禁用模式 2027,则回退到wcwidth |
| Gnome | 4 | ❌ | 不支持塑形,显示为两个独立的表情符号 |
| iTerm | 2 | ❌ | 始终执行字形簇化 |
| Kitty | 4 | ❌ | |
| Tmux | 4 | ❌ | 当它与终端模拟器不一致时尤其有趣 |
| Terminal.app | 6 | ❌ | 🤡 活在自己诡异的小世界里 |
| Warp | 4 | ❌ | 不支持塑形,显示为两个独立的表情符号 |
| Wezterm | 2 | ✅ | 始终执行字形簇化 |
| Windows Terminal | 5 | ❌ | 🧐 将 ZWJ 视为一个单元格,显示为两个独立的表情符号 |
| Xfce | 4 | ❌ | 不支持塑形,显示为两个独立的表情符号 |
| xterm | 4 | ❌ | 不支持塑形,显示为两个独立的表情符号 |
目前对模式 2027 的支持仍然很少,也相对缺乏。不过,有趣的是可以看到各终端报告的宽度差异之大。“2”和“4”都是可以理解的值,而报告“5”和“6”的终端则活在一种奇怪的现实中。
一个特殊的挑战是像 tmux 或 zellij 这样的终端复用器。注意上表中 tmux 使用wcwidth,因此会让光标前进四格。但 tmux 本身又运行在终端模拟器中,打印时终端也会看到这个值。如果 tmux 和终端不一致,光标就会失步,由此产生的 bug 可能会相当滑稽3。
程序作者今天能做什么?
如果你是在终端中运行的程序(文本编辑器、CLI、TUI 等)的作者,今天就有一些方法可以更恰当地处理字形簇。
第一,你可以完全不在乎。如果你的程序不需要追踪光标位置,不需要手动换行等等,那么你完全可以不用管,让终端自行处理。
第二,你可以也应该查询对模式 2027 的支持,并在可行时尝试使用模式 2027。你可以使用标准序列 DECRQM(请求模式):CSI ? 2027 $ p 来查询是否支持模式 2027。
第三,你可以在输出一段文本后使用CSI 6 n查询光标位置。终端随后会报告光标所在位置,你可以据此计算文本的宽度。
你不应该做的是假定终端一定会表现为wcwidth的行为或字形簇化的行为。从上一节的表格中可以看到,无论作哪种假设,在多个终端模拟器上都会出错,即使只考虑那些流行或主流的终端也是如此。
希望未来会有更多终端和终端程序支持模式 2027 以及正确的字形簇化。如前所述,这不仅仅影响表情符号这类“可爱”的功能,还关系到阿拉伯语等世界上的多种语言。
如果你不是终端或终端程序的作者,也希望这篇博文能让你有所收获。对我而言,实现一个终端模拟器的过程无疑让我大开眼界,看到了文本处理的复杂性以及历史遗留行为带来的负担。
最后,我想特别感谢提出模式 2027 的 Christian Parpart。Christian 是我看到的第一位非常公开地谈论字形簇与终端问题,并决定采取行动加以解决的人。谢谢你!
评论
登录后参与讨论