重构英语:第 18 个月
原文由 Michael Lynch 于 发布,订阅该博客
一句话总结
这本书写完了!嗯,算是吧。
第一次来?
嗨,我是 Michael。我是一名软件开发者,也是几家小型独立科技公司的创始人。目前我正在写一本书,叫Refactoring English: Effective Writing for Software Developers。
每个月,我都会像这样发布一篇回顾,分享这本书的进展以及我整体的工作情况。
亮点
- 我已完成书稿的全部 22 章。
- 我曾以为 AI 能让原型开发更快,但现在不太确定了。
目标评分
每个月初,我都会定下当月想要完成的目标。以下是本月的完成情况:
让 Refactoring English 达到“内容完稿”
- 结果:已完成全部章节。
- 评分:A
过去六周里,总感觉再有一周就能写完,现在终于把所有章节都完成了,松了一口气。
开发一款让 Refactoring English 读者在阅读时可以直接反馈的工具
- 结果:工具只完成了约 40%。
- 评分:C
这原本看似是个两三天就能搞定的项目,但实际做起来才发现比想象中困难得多,尤其是受到了大阻塞的影响。
Refactoring English 数据
| 指标 | 2026 年 4 月 | 2026 年 5 月 | 变化 |
|---|---|---|---|
| 独立访客 | 2,578 | 1,752 | -826 (-32%) |
| 预售收入 | $587.73 | $407.61 | -$180.12 (-31%) |
哎呀,我一直在忽视营销,数据也因此很不好看。
我当时一心想赶完书的最后几章,所以把精力全放在写作上,完全没做任何营销。
漏洞赏金数据
我还在继续做安全漏洞赏金,不过投入的时间有所减少。本来计划按 70/30 来分配时间,现在大概是 60/40 吧。
我主要合作的那家厂商又为我的报告支付了 7000 美元(累计已达 17000 美元),但他们处理报告的速度变慢了,所以我基本已经不再去他们的代码里找新漏洞了。
我也向其他几个项目提交了漏洞,想看看有没有处理得快的,结果都没有:
- KeePassXC - 我在 5 月 18 日向 Zero Day Initiative 提交了一个远程代码执行漏洞,但至今没有收到任何回复。
- 对于 KeePassXC 的用户来说,这并非零点击攻击,也不会因为访问恶意网站就导致你的数据库被攻破,所以不用太担心。
- Cloudflare - 我在 5 月 22 日通过 HackerOne 提交了一个拒绝服务/逻辑绕过问题。没有回复。
- Proton - 我提交了一个低危问题。他们要求提供视频形式的概念验证,所以我在 5 月 29 日做了一个发给他们,对方让我等待后续通知。
这本书何时才算“完成”?
虽然已经写完了所有章节,让人松了一口气,但我并不认为这就算是正式“完成”了。
过去一年半里,我基本上是一次专注于一章来写这本书的。我还从来没有从头到尾完整地读过一遍,以确保全书的一致性。在正式定稿之前,我想至少完整通读几遍。
为什么我没有持续修订这本书?
我原本计划根据读者的反馈持续修改书稿。这样等写到最后一章时,书的其他部分已经经过多轮基于读者意见的修订,基本就算是完成了。
实际上,我整合读者反馈的程度远低于预期。
我发现很难在修订旧章节和撰写新章节之间分配精力。如果花一周时间去改旧章节,感觉就不像是在推进。而每新增一章,公开的进度条就会多填一点,这很有成就感。
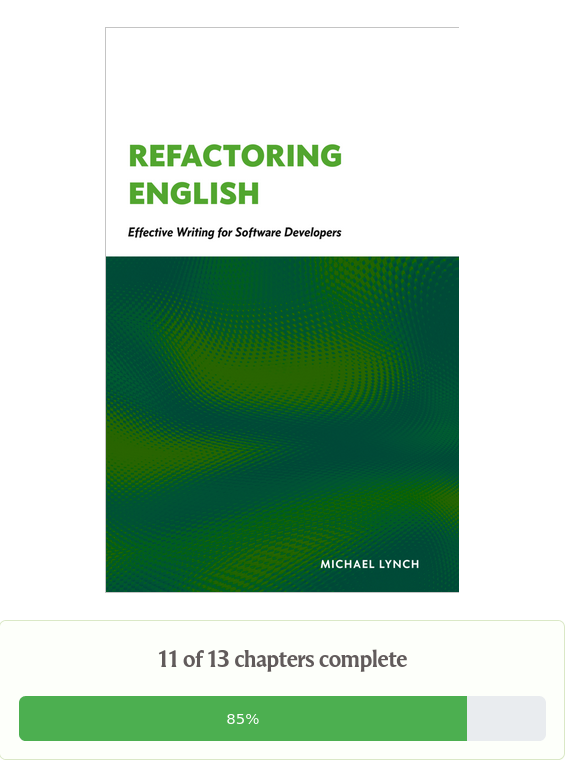
书籍网站上的进度条
另一个没有持续修订的原因是,我联系读者的次数远没有计划的那么多。部分原因是,我总觉得写作进度落后,所以心里一直想着:“先把这章写完,然后再去多联系读者。”
但即便联系了读者,也很少对书稿产生实质影响。最常见的读者回复是“我很喜欢这本书”或“我还没开始看”。
偶尔收到详细的反馈时,我也不总清楚该如何采纳。有些情况下我认同反馈,处理起来就很简单。但多数时候,读者会建议增加一些我认为没必要的内容。这并不是说读者错了,只是在违背自己直觉去改之前,我希望能看到更多读者都提到同一个问题、形成一种趋势,而我收到的反馈还不足以看出这种趋势。
我的读者反馈工具
现在所有章节都已完成,我感觉有更多精力去联系读者了。
我很喜欢 Help this Book 这个想法——它是一个能让读者直接在电子书中提交反馈的网页应用,但我不想把所有反馈都存放在第三方那里,还要每月付费。
我看到 Julia Evans 为自己的产品定制了一套读者反馈工具,觉得很不错,所以我也在做类似的东西。
我正在开发一个网页应用,让读者更方便地对我的书提供反馈。
AI 项目与“大阻塞”
总体来说,我发现 AI 确实能提升我编程时的效率。在解决 git 合并冲突、调试不熟悉的代码或制作简单工具这类任务上,AI 的优势非常明显。
我曾以为 AI 特别适合帮我启动新项目,但现在不太确定了。我总是会遇到我称之为“大阻塞”的情况。
直接让 AI 做原型
六个月前,我会给 AI 智能体一个高层次的需求概述,让它去实现一个基础的 v1 版本。我知道它产出的代码会比较乱,但毕竟只是原型,我可以不断给出反馈,直到它符合我的编程品味。
结果证明,清理一个糟糕的原型比我想象的要难得多。一旦原型烂到一定程度,我甚至很难搞清楚代码到底想实现什么。
AI 似乎有一种奇怪的倾向,总要为已有的代码辩护。如果我指出某个组件让人困惑,因为它对同一份数据遍历了三次,它就会坚持说由于 X、Y、Z 的原因必须遍历三次。但它从不会去质疑 X、Y、Z 本身是不是人为制造的限制。
这就是阻塞。我被困在 AI 构筑的一堵由混乱代码组成的高墙面前,难以逾越。
如果不修复核心逻辑,问题只会越来越严重。代码异味像霉菌一样滋生,并蔓延到整个代码库。我是在脆弱的地基上继续搭建,而 AI 只会不断复制已有的糟糕模式。
拆解原型
好吧,有个简单的解决办法:让 AI 智能体分更小的块来创建原型。把 AI 管得更严一些,不让它跑得太偏。不要让 AI 一次性做出整个原型,而是先让它做一个欢迎页。等审核合并之后,再加一个简单功能,依此类推。
这个办法在遇到像身份验证这样复杂的模块之前都挺管用。AI 会生成一个包含 2000 到 5000 行混乱代码的拉取请求,这又成了一堵高墙。我想不出还能怎么进一步拆分这个功能,于是就被这个巨大的 PR 卡住了,又是一次大阻塞。
一个 4000 行代码的改动,审核时间不仅是 400 行改动的 20 倍,还需要更长的连续审核时间。如果我有 20 分钟的空档,可以处理 400 行的改动;但如果是 4000 行,光是理清上下文就要花 20 分钟。要想在不把时间都浪费在上下文切换上的前提下,对 4000 行改动做出实质性进展,我需要 90 分钟的完整时间段,这对于周末项目来说很难挤出来。
示例:为 Little Moments 实现身份验证
举个例子。在 Little Moments 中,我打算用魔法登录邮件来实现身份验证。好几周里,我都想不出如何在不引入无用代码或导致功能损坏的情况下拆分这个功能。登录流程怎么可能只实现一半呢?
在花了好几周一点点啃那个巨大的 PR 之后,我才意识到,其实是可以实现“一半登录”的。我维护的另一款应用 PicoShare 就有一个简单的验证流程。该应用假定只有一个授权用户,所以验证只需要一个通行口令,甚至不需要用户名/密码组合。与其从无验证直接一口气切换到基于邮件的验证,我可以先从无验证过渡到口令验证。
于是,我先让口令验证跑通了,但从口令验证再到魔法邮件登录,仍然是一个相当庞大的 PR,需要花几周时间来审核。在断断续续折腾了好几天后,我意识到还可以进一步拆分。
与其真正发送带登录链接的邮件,我可以先直接把用户重定向到本来要通过邮件发送的那个链接。这仍然是一个 1700 行代码的 PR,但比起真正发邮件的版本已经好处理多了。而且这样一来,真正发送邮件的那部分就只剩下 1000 行代码了。
AI 为何让这件事更难
让我怀疑 AI 在这类工作上是否真的带来净收益的是,我知道如果不用 AI,我本该能更早发现这些拆分问题的机会。我绝不会先造出一个 4000 行的 PR,然后才说:“嗯,这好像有点大。”随着 PR 越来越大,处理起来会越来越痛苦,所以我自然会去寻找把它拆成更小块的机会。
AI 打破了这种自然的反馈循环。用 AI 时,创建一个 4000 行的 PR 毫无痛苦可言,因为它在你查邮件的两分钟里就生成好了。我还可以轻易地给出修改意见来改进这个巨大的 PR,并感觉自己在取得进展,但正是这个庞大的改动,让我很难识别出哪些部分可以抽出来单独做成更小的改动。
既然已经认识到为复杂改动生成庞大而难以管理的 PR 是多么容易,我就可以改变使用 AI 的方式,在前期投入更多精力,把功能拆成更细小的改动。
收尾
完成了哪些事?
- 发布了本书的最后几章。
- 为书籍反馈应用创建了部分原型。
- 为 Little Moments 部分实现了身份验证功能。
- 为 PicoShare 发布了两个新版本。
经验总结
- 使用 AI 消除了促使我以更小粒度构建软件的自然反馈循环。
- 我认为解决办法是在复杂功能的生命周期早期就更努力地将其拆分成更小的块,并更严格地检查 AI 的输出。
下月目标
- 至少投入五小时改进 Refactoring English 网站。
- 为 Refactoring English 网站吸引 3 万名独立访客。
- 完成我的读者反馈工具。
评论
登录后参与讨论