修复我的 Golang Web 应用中的内存耗尽 Bug
原文由 Michael Lynch 于 发布,订阅该博客
今年早些时候,我创建了一个名为 PicoShare 的开源应用。这是一个用于分享文件的简单 Golang Web 应用。我用它来发送那些大到无法作为邮件附件的文件,同时又不想让接收方去折腾 Dropbox 或 Google Drive。
几个月前,我发现我的 PicoShare 服务器每隔几天就会挂掉。查看日志后,我看到了一个内存不足的错误:

当时没时间去排查崩溃原因,就直接把服务器内存从 512 MB 加到了 1 GB。结果还是会崩,于是又加到了 2 GB。
靠一味加内存来解决崩溃问题总让人不踏实,所以过去两周里我一直在调试这些崩溃,并在 Twitter 上分享了进展。
到目前为止,我已经修复了所有导致崩溃的问题,并在过程中学到了不少关于 Go、SQLite 和调试的有用经验。
如果你想看整个过程的实时记录,可以去看那条 Twitter 串。如果想看一个整理过的精简总结,请继续往下读。
前言:我对 SQLite 的用法有点特别
我在 PicoShare 上做的一个比较奇怪的架构决策,是把所有文件数据都存进 SQLite。这是个不太常见的选择,因为 Web 应用通常是把用户上传的文件直接存在文件系统上,而不是数据库里——尤其是当上传文件大小可能任意大的时候。
把文件数据写入 SQLite 的好处在于,PicoShare 的所有应用状态都在同一个数据库里。这本身没什么特别,但我设计 PicoShare 时让它集成了 Litestream——一个将 SQLite 数据库复制到云存储的工具。Litestream 相当于让 PicoShare“免费”获得了备份与恢复能力。我可以把服务器完全推倒重来,然后在任意地方重新部署(甚至换一家云服务商),PicoShare 醒来后依然保持完全相同的状态,继续提供原来的所有文件。
调试过程
复现问题
PicoShare 只是每隔几天才崩一次,所以我的第一步是想办法更快地稳定复现崩溃。
我通过在只有 256 MB 内存的 Fly 实例上部署 PicoShare,然后上传大文件,成功复现了这个问题。我用的是短片 Big Buck Bunny 的高清版本,大小从 269 MB 到 618 MB 不等。

我用短片 Big Buck Bunny 作为测试文件,因为它足够大,适合测试大文件上传。
并行上传两份 618 MB 的版本,总能在大约一分钟内稳定地让 PicoShare 因内存不足而挂掉。
使用分析工具定位内存膨胀
调查的第一个突破来自 Ben Johnson——Litestream 的作者、最近加入 Fly 团队的成员。Ben 提交了一个详细的 pull request,解释了一行代码是如何导致 PicoShare 消耗大量内存的。
Ben 在性能分析方面经验丰富,他通过新建一个单元测试并在测试后对内存进行分析,复现了这个问题。后来他又教了我一个更简单的获取同样信息的方法,下面我会介绍这个方法,你也可以在他的 pull request 中找到他最初的技术细节。
事实证明,Go 标准库自带一个调试 Web 应用问题的神器。你只需要在导入中加入这一行:
_ "net/http/pprof"这样一来,运行应用时就会多出一个 /debug/pprof/ 路由,里面包含大量有用的调试信息。

我很惊讶加上它竟然如此简单。这个 Web 界面里有很多有意思的数据,而我用到的是 heap。要使用它,我先向 PicoShare 上传了一个大文件,然后运行了如下命令:
go tool pprof \
  -http=:8081 \
  -alloc_space \
  call_tree \
  http://localhost:4001/debug/pprof/heap
这会弹出一个 Web 界面并渲染出这样一张图:

在底部,你可以看到一个标为 bytes makeSlice 63.99 MB 的大红色块,意味着 PicoShare 已分配内存中有 64 MB 来自 Go 的 makeSlice 函数。
makeSlice 属于 Go 标准库,而不是我的代码。为了找到是 PicoShare 中的哪段代码导致了这次内存分配,我沿着图向上追溯,直到找到一个 PicoShare 的函数:

这个调用链中最后一个属于 PicoShare 的函数是 handlers.fileFromRequest,它调用了 Go 标准库的 *Request.ParseMultipartForm。该函数负责解析 multipart HTTP 数据,这正是 PicoShare 接收文件上传的方式。
ParseMultipartForm 接受一个 maxMemory 参数,文档中是这样描述的:
整个请求体都会被解析,其中文件部分的最多 maxMemory 字节会被保存在内存中,剩余部分则作为临时文件存储在磁盘上。
PicoShare 的调用是这样的:
r.ParseMultipartForm(32 << 20) // 32 MB虽然我们指定了 32 MB 的限制,Go 却分配了 64 MB 的内存。
Ben 尝试把 maxMemory 参数降到 1 << 20(1 MB),ParseMultipartForm 的内存占用随即降到了只有 2.5 MB:

内存下降幅度非常大,我一度以为 Ben 已经彻底解决了问题。
遗憾的是,我部署了带 Ben 修复的测试版本后,依然会崩溃。
应用 Ben 的修复后,PicoShare 在崩溃前能承受更大的负载,看起来的确有改善。但当我并行上传三个大文件时,服务器还是以同样的内存不足错误挂掉了。
调用 ParseMultipartForm 后释放资源
通过搜索,我发现了 ParseMultipartForm 的另一个坑。
文档里并没有提醒读者,但调用者有责任调用 r.MultipartForm.RemoveAll() 来释放 Go 在 ParseMultipartForm 期间分配的资源。所以,每次调用 ParseMultipartForm 我都在泄漏内存。
更新(2022-08-11):Damien Neil 在评论中指出,Go 本应自动清理这些资源。在 Go 的 HTTP/1 实现中会自动清理资源,Damien 也已提交了一个 bug 修复,让 Go 的 HTTP/2 实现保持一致。
为了解决这个泄漏,我重写了代码来清理 multipart 资源:
multipartMaxMemory := 1 << 20 // 1 MiB
if err := r.ParseMultipartForm(multipartMaxMemory); err != nil {
  return err
}
// Free form resources before returning from function.
defer func() {
  if err := r.MultipartForm.RemoveAll(); err != nil {
    log.Printf("failed to free multipart form resources: %v", err)
  }
}()
这个修复看起来很有希望,因为在显式释放资源后,我在 Fly 上看到内存占用大幅下降:

可惜的是,即使有了这个修复,崩溃依然在继续。
优化下载
这时 Dan Wilhelm 开始关注这条 Twitter 串。尽管他此前一天 Go 都没写过,还是挽起袖子在自己的开发机上开始摆弄起代码。
Dan 注意到下载文件时内存占用会飙升。这很奇怪,因为下载本不该消耗太多内存。解析 multipart 表单很复杂,有很多因素可能导致内存膨胀,但提供文件下载应该相当直接才对。
PicoShare 把所有文件数据以 328 KB 为一块存储在 SQLite 中。这本不该占用太多内存,因为我们应该只需要把几块数据读进内存、发给客户端,然后释放即可。
Dan 在负责从数据库读取 PicoShare 文件数据的代码中发现了一个 bug。看看你能不能找出来:
func (fr *fileReader) populateBuffer() error {
  if fr.offset == int64(fr.fileLength) {
    return io.EOF
  }

  startChunk := fr.offset / int64(fr.chunkSize)
  stmt, err := fr.db.Prepare(`
      SELECT
        chunk
      FROM
        entries_data
      WHERE
        id=? AND
        chunk_index>=?
      ORDER BY
        chunk_index ASC
      `)
  if err != nil {
    log.Printf("reading chunk failed: %v", err)
    return err
  }
  defer stmt.Close()

  var chunk []byte
  err = stmt.QueryRow(fr.entryID, startChunk).Scan(&chunk)
  if err != nil {
    return err
  }

  // Move the start index to the position in the chunk we want to read.
  readStart := fr.offset % int64(fr.chunkSize)

  fr.buf = bytes.NewBuffer(chunk[readStart:])
  fr.offset += int64(len(chunk)) - readStart

  return nil
}
问题出在 SQL 查询的 WHERE 子句中:
WHERE
    id=? AND
    chunk_index>=?
这个查询本应只取回一块文件数据,结果却把目标块以及之后的所有块都读了出来。
修复方法很简单,只需把 >= 改成 =:
WHERE
    id=? AND
chunk_index=?附注:读到这段代码时,我还意识到自己在不需要的地方使用了预编译语句,不过我觉得这应该没有影响内存。
Dan 的改动是在下载一侧的,所以我本来也没指望它能解决上传时的崩溃——事实也的确没有。但在提供下载的性能上却有了巨大提升。尤其是在串流视频或音频这类内容时,在文件中跳转到不同位置,PicoShare 的响应要灵敏得多。
移除 SQLite 事务
在 Twitter 讨论中,有几个人提出 PicoShare 的 SQLite 事务很可能导致了内存膨胀。
PicoShare 向 SQLite 写入文件数据时,是放在一个事务里做的。目的是确保数据库始终处于一致状态。
通过使用事务,SQLite 能保证即使部分写入失败,也不会出现只有半个文件在库里的状态。同时也能确保不会意外地只写入了文件元数据而没写入文件内容,反之亦然。
搜索后发现,大型 SQLite 事务可能是内存膨胀的来源之一,所以我觉得值得一试。我尝试改为立即提交到 SQLite 而不是使用事务,但内存依然会膨胀。看起来事务并没有带来什么区别。
内存膨胀可以接受,崩溃不行
在这个阶段,我从三个不同角度测量内存占用,结果彼此都不一致:
- Go 调试指标显示的已分配内存
- 虚拟机内
htop显示的内存 - 来自虚拟机宿主机的 Fly 内存指标


我用来测量内存占用的不同工具给出的结果互相矛盾
特别是,Fly 的指标经常显示内存已占满,而 Go 和 htop 却显示占用很低。这让调试非常让人沮丧,因为越往深挖,内存测量结果就越偏离我实际观察到的崩溃行为。
扭转局面的洞见来自 Andrew Ayer,他指出内存膨胀很可能是一个误导:

Fly 的 CEO Kurt Mackey 也在讨论串中现身,证实了 Andrew 的推测:

也就是说,Fly 的内存指标包含了页缓存,但如果运行中的应用需要内存,虚拟机理应会回收这部分内存。
这是一个重大的认识。由于难以稳定触发内存不足的崩溃,我一直把内存膨胀当作崩溃的近似指标。但只要虚拟机仍有足够内存让进程继续运行,内存膨胀本身并无大碍。
现在我必须重新评估一切。之前我否掉某些修复,是因为它们导致了无害的内存膨胀,还是因为我确实观察到了崩溃?
重新审视 SQLite 事务
鉴于 Andrew Ayer 关于内存膨胀的说法,我重新审视了 PicoShare 的 SQLite 事务。当初尝试无事务的实现时,我看到的是崩溃还是仅仅是内存膨胀?我已经记不清了。
我又试了一次无事务的实现。果然,内存膨胀了,但 PicoShare 依然在运行。我并行上传了三个 618 MB 的文件,每次上传都成功了,PicoShare 也继续正常响应 HTTP 请求。

成功了!我终于触及了性能问题的根源。
至少我当时是这么以为的……
我让服务器跑了一整夜,第二天早上查看时,它又以同样的内存不足崩溃挂掉了。

去掉 SQLite 的 vacuum 操作
我立刻怀疑夜间的崩溃与 SQLite 的 VACUUM 命令有关,该命令会压缩数据库文件以回收未使用的磁盘空间。
崩溃时根本没人在使用 PicoShare 服务器,但时间点恰好与 PicoShare 计划的数据库维护吻合。每隔七小时,PicoShare 会从数据库中清理过期条目,并执行一次 VACUUM 来回收未使用的磁盘空间。
我在服务器上测试运行 VACUUM 命令,发现它确实减小了主 .db 文件的大小,但却让 SQLite 预写日志变大了。

这时 Ben 问我到底为什么需要 VACUUM:
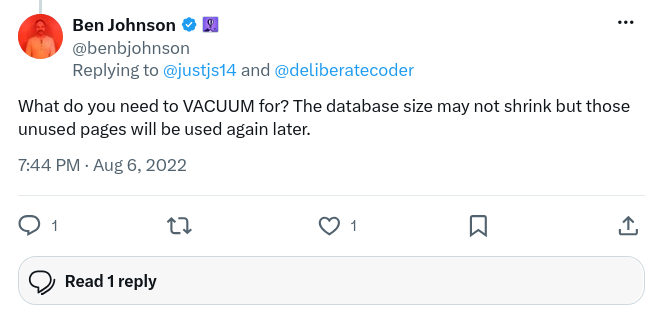
是啊,我到底为什么要这么做?
最初发布 PicoShare 时,有用户抱怨删除文件后磁盘空间没有被释放。这对我自己倒没影响,因为我在 Fly 虚拟机上用的是固定大小的磁盘卷,用多少空间都无所谓。但定期做一次 VACUUM 实现起来很简单,所以我就加上了。
斟酌之后,我决定改变 PicoShare 的默认行为,让 VACUUM 默认关闭,但用户可以通过命令行参数来启用它。
dbPath := flag.String("db", "data/store.db", "path to database")
vacuumDb := flag.Bool("vacuum", false, "vacuum database periodically to reclaim disk space")
flag.Parse()
成功:PicoShare 在 256 MB 内存上稳定运行
在默认禁用 VACUUM 并加上其他性能修复后,PicoShare 终于能在低内存下稳定运行了。
我在只有 256 MB 内存的 Fly 虚拟机上让 PicoShare 连续跑了 24 小时,没有出现任何崩溃。


过去 24 小时 100% 在线
其他收获
除了上面提到的收获,在这次调试过程中我还学到了一些额外的有用经验。
优化构建-测试循环
有一件事我希望能更早去做,那就是优化构建-测试循环。为了验证任何一个假设,我的流程是:
- 将改动部署到 Fly(2-3 分钟)
- 上传一个大文件(1-2 分钟)
- 等待 Fly 的内存指标更新(30-60 秒)
这样一来,仅仅测试一个改动就要花掉多达六分钟,而且每一步都需要手动操作。这还没算上写代码改动的时间。
我最初尝试在限制内存的 Docker 容器中运行 PicoShare,但它从未崩溃。
RAM_LIMIT="64m"
PORT=3001
PS_SHARED_SECRET="somesecretpass"

docker run \
  --memory "${RAM_LIMIT}" \
  --env "PORT=${PORT}" \
  --env "PS_SHARED_SECRET=${PS_SHARED_SECRET}" \
  --publish "${PORT}:${PORT}/tcp" \
  --name picoshare \
  mtlynch/picoshare:1.1.7
$ docker stats
CONTAINER ID NAME CPU % MEM USAGE / LIMIT MEM % NET I/O BLOCK I/O PIDS
1ababd398113 picoshare 3.82% 63.68MiB / 64MiB 99.50% 278MB / 208MB 6.09GB / 7.1MB 21我至今仍不明白为什么 PicoShare 在 Docker 下的表现与在真实虚拟机中不同,但我猜测 Docker 对内存的限制并没有虚拟机那么严格。
当 Dan Wilhelm 汇报他在本地运行 PicoShare 并观察内存占用所取得的进展时,我才意识到自己每次改动都部署到 Fly 上浪费了多少时间。我也尝试在家里的虚拟机服务器上运行 PicoShare,但它从未像在 Fly 上那样崩溃或出现内存膨胀。
最终奏效的办法是在 Fly 上搭建自己的开发环境。我写了一个 Dockerfile,里面包含了 PicoShare 源码和一些开发工具,并部署到 Fly。之后,我就可以用 fly ssh console 在服务器上打开一个 shell,快速测试代码改动。
虽然还不是特别快,因为 Fly 的内存指标更新大约有 30 秒的延迟,但相比每次都要从头部署,已经是巨大的改进。
用描述性强的 git 分支和提交信息来记录笔记
在这次调查中我发现的一个有用技巧是,为每个假设单独开一个 git 分支,然后用提交信息记录结果:

由于有太多不同的假设交织在一起,很难记住测试每个想法时代码处于什么状态。例如,有一次我看到的崩溃其实是调试过程中自己引入的新 bug 导致的。
记录下代码当时的状态以及我是如何测试的,有助于理清思路、避免重复劳动。
Go 的测量工具看不到 cgo 中的内存分配
我最早的调试步骤之一,是在 PicoShare 中加了一个页面来展示来自 runtime.ReadMemStats 的一些内存指标(后来我意识到 net/http/pprof 能更好地做到这一点)。

James Tucker 指出,这种测量会排除通过 cgo 分配的所有资源:

我的确是通过 cgo 使用 SQLite 的。PicoShare 用的是 mattn/go-sqlite3,这是 Go 最流行的 SQLite 库。
而 cgo 会让 Go 无法显示准确的性能指标,这也说得通。如果你用 Go 去调用外部 C 代码,Go 自然无法追踪外部代码中的资源。
为了解决这个问题,我尝试了 modernc.org/sqlite,这是一个纯 Go 实现的 SQLite。但不知为何,即使换成纯 Go 代码,我也看不到资源泄漏。
Fly 的磁盘性能快得离谱
曾有 Twitter 上的评论者提出,我可能是因为磁盘写入耗尽了内存。如果 PicoShare 向 Fly 虚拟机磁盘写入的速度超过了磁盘将数据刷到物理介质的速度,数据就会在内存中排队。
为了验证这个猜想,我使用了之前从未用过的 fio 磁盘基准测试工具。我一度以为自己用错了工具,因为它报告的写入速度高达 3353 MB/s,对于云虚拟机来说快得不像话。作为对比,这比我在家里的 NAS 服务器上做同样测试时快了约 30 倍。
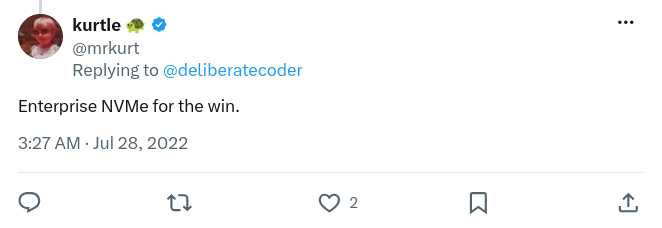
Kurt Mackey 证实这些测量结果很可能是准确的,因为 Fly 的本地磁盘是企业级 NVMe 硬盘:
走过的弯路
尽管我多希望这次调查是一次稳步向前的过程,但我还是走了不少弯路,追踪了许多最终无果的假设。下面是其中一些。
怀疑 Litestream
调试的第一条规则是假定问题出在自己的代码里。但这次我违背了这条规则,部分原因是光想到要去追查这些 bug 就觉得工作量巨大。
话虽如此,怀疑 Litestream 也有合理的理由。尽管 PicoShare 对 SQLite 的用法有点奇怪,但在 SQLite 里存 1 GB 数据倒也不算特别离奇。Litestream 相对较新,又以新颖的方式使用 SQLite,所以联想到崩溃可能来自 Litestream,也并不算太牵强。
即便怀疑 Litestream,我也不想给它的维护者 Ben Johnson 增加额外负担。我知道 PicoShare 对 Litestream 来说是个不寻常的用例,而且我也没有一个能隔离问题的简单复现。
但到了五月,Fly 收购了 Litestream 并聘请 Ben 来维护它。现在似乎正是拿这个问题去打扰 Ben 的绝佳时机,因为这同时涉及 Litestream 和 Fly!
我在 Litestream 上提了一个 bug,说明了我已尝试过什么以及为什么认为问题与 Litestream 有关。结果 15 分钟后,我就在禁用 Litestream 的情况下成功让 PicoShare 崩溃了,于是又把 bug 关掉了。
不过,在 Litestream 上提 issue 还是有用的,因为它迫使我足够严谨地梳理问题,写出一份详细的 bug 报告。同时也激起了 Ben 的好奇心,即使后来已经明确 Litestream 不是原因,他依然提供了许多有用的建议。
怀疑 Fly
当我在本地虚拟机或 Docker 中无法复现崩溃时,我开始怀疑问题出在 Fly 那边。这似乎不太可能,因为我做的事并不算特别离奇,如果真是 Fly 的问题,Fly 的其他用户不可能没发现自己的部署会因内存耗尽而挂掉。
不过,我还是想排除 Fly 的可能性。于是我把 PicoShare 部署到了 Lightsail——亚马逊的托管 Docker 容器服务。他们没有 256 MB 内存的选项,所以我部署在了 512 MB 的实例上。几分钟内,我就在那里复现了崩溃,从而排除了 Fly 是罪魁祸首的可能。
/tmp 并非内存盘
在 Twitter 讨论中,有几位评论者提出 Fly 可能把临时目录挂载成了内存盘。Go 的 ParseMultipartForm 函数会把文件上传保存在临时目录中,如果 Fly 把临时目录挂为内存盘,那就能解释为什么常规的文件上传会耗尽内存。
但当我运行 lblk 时,并没有看到任何表明 /tmp 或其他临时目录是内存盘的迹象。系统看起来只有常规磁盘:
$ lsblk
NAME MAJ:MIN RM SIZE RO TYPE MOUNTPOINTS
vda  254:0    0  128M  0 disk
vdb  254:16   0    8G  0 disk /
$ du -h /tmp/*
149.3M /tmp/multipart-338465586
7.66 /tmp/test1
手写 multipart 表单解析器
Go 标准库的 ParseMultipartForm 函数似乎比文档声称的限制消耗更多内存,这是一个危险信号。我还注意到,即使我调用 ParseMultipartForm 后丢弃了字节,内存依然会被占满。
为了看看能否绕开 ParseMultipartForm 的问题,我尝试为自己的特定场景手写了一个精工细作的 multipart 解析器。
可惜,我的 multipart 解析器表现并不比标准库好,不过在更底层摆弄 multipart 数据倒也挺有趣。
限速上传
我很好奇,如果放慢上传数据的速度,是否会对内存有影响。我尝试通过让 Chrome 模拟 3G 网速从客户端限速上传,但 PicoShare 的表现依旧。
我也尝试在服务端限速以降低写入磁盘的速度,但同样没有任何效果。
不过我倒是学到了在 Go 中限速 I/O 有多简单。如果你用的是 io.Reader 接口,只需像这样用一个限速的 Reader 包装一下即可:
import "github.com/juju/ratelimit"

...

throttleRate := 1 << 20 // 1 MB
bucket := ratelimit.NewBucketWithRate(float64(throttleRate), throttleRate)
throttledReader := ratelimit.Reader(reader, bucket)

w := file.NewWriter(tx, metadata.ID, d.chunkSize)
if _, err := io.Copy(w, throttledReader); err != nil {
  return err
}
PicoShare 1.2.0
周末,我发布了 PicoShare 的 1.2.0 版本,其中包含了通过这次调查发现的所有性能问题的修复。
致谢
非常感谢所有帮助我调查这个问题的人,尤其要特别感谢以下几位付出了额外努力的朋友:
评论
登录后参与讨论