为慢网络打造的阅读模式代理
原文由 Matthias Endler 于 发布,订阅该博客
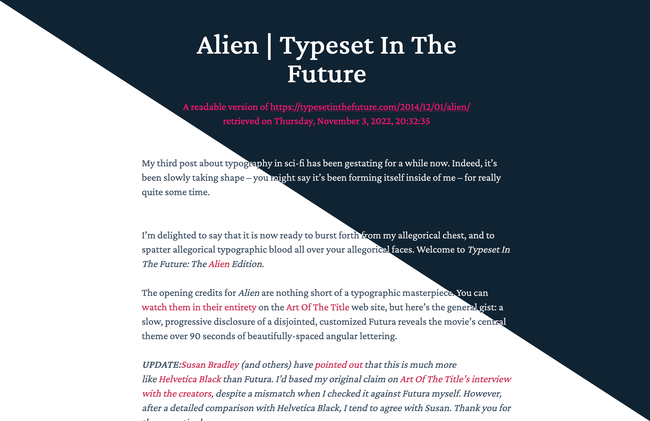
太长不看: 我做了一个服务,可以把任意文章转换成赏心悦目、适合打印的版本。它类似于 Firefox/Safari 中的阅读视图,但也能在老旧浏览器上使用、可以分享,并且专注于优美的排版。查看源代码。
网络曾是个充满乐趣的地方。
如今呢?啧。追踪器、广告、臃肿的代码、全屏弹窗、自动播放的视频……一切都让人精疲力竭。
我只想捧着一杯好茶,无干扰地读一篇长文,猫咪在窗台上酣睡,窗外轻雪飘落。
慢网络
我是慢网络运动以及把一件事做好的小网站的忠实拥护者。
为了无干扰地阅读长文,我在 Firefox 中使用阅读视图,虽然它并非总是有效,界面也不算最美观,但我还是很喜欢。
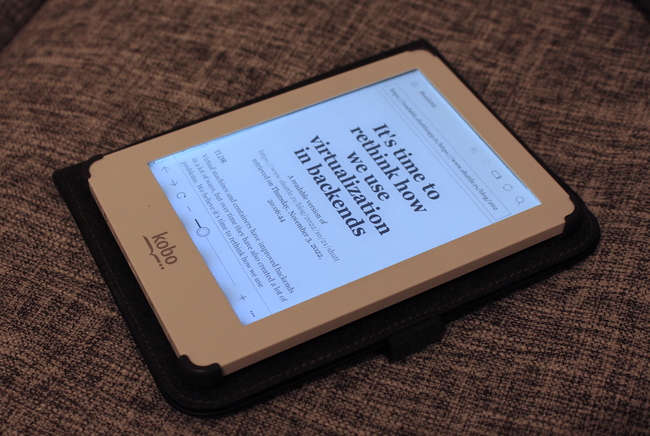
其他浏览器也有阅读模式,但有些浏览器——比如 Chrome——把它藏在了实验性功能开关后面。还有一些浏览器,比如我电子书阅读器上的浏览器,则根本没有阅读模式,这让我在主要用于阅读的设备上只能忍受糟糕而缓慢的浏览体验。
于是我搭建了一个阅读模式即服务,专注于优美的排版,并且能在所有浏览器上使用。它非常简单,但我用它在旧设备上阅读文章,它还能让低带宽地区或旅途中的内容访问变得更轻松。
动手搭建
前段时间我看到一篇关于circumflex,一款 Hacker News 终端客户端的帖子。这个工具在渲染网页内容方面做得相当出色,我便想能否把它改造成一个代理服务器。
Go 语言的清理代码在这里:
func GetArticle(url string, title string, width int, indentationSymbol string) (string, error) {
    articleInRawHTML, httpErr := readability.FromURL(url, 5 * time.Second)
    if httpErr != nil {
        return "", fmt.Errorf("could not fetch url: %w", httpErr)
    }
    // ...
}他们使用的是go-readability,也就是 Mozilla Readability 的 Go 语言移植版。Rust 对应的版本是 readability,用起来也非常简单:
use readability::extractor;

fn main() -> Result<(), Box<dyn std::error::Error>> {
    let response = extractor::scrape("https://endler.dev/2022/readable")?;
    println!("{}", response.content);
    Ok(())
}
在编写完整的代理服务器之前,我们先来写一个简单的 CLI 工具,它接收一个 URL 并输出一份干净、易读的 HTML 文件。
use readability::extractor;
use std::fs::File;
use std::io::Write;

fn main() -> Result<(), Box<dyn std::error::Error>> {
    // read the URL from the command line
    let url = std::env::args().nth(1).expect("Please provide a URL");

    let response = extractor::scrape(&url)?;
    let mut file = File::create("index.html")?;
    file.write_all(response.content.as_bytes())?;
    Ok(())
}
输出效果已经出乎意料地不错。接下来我加了一个简单的 HTML 模板来包裹返回的内容。
<!DOCTYPE html>
<html lang="en">
  <head>
    <meta charset="UTF-8" />
    <title>Document</title>
    <link rel="stylesheet" href="yue.css" />
    <style type="text/css">
      body {
        margin: 0;
        padding: 0.4em 1em 6em;
        background: #fff;
      }
      .yue {
        max-width: 650px;
        margin: 0 auto;
      }
    </style>
  </head>
  <body>
    <div class="yue">{{content}}</div>
  </body>
</html>
暂时没必要用完整的模板引擎;我们只需要用 str::replace 把 {{content}} 占位符替换成实际内容就行。 😉
代理搭建
用 shuttle 搭建代理非常简单。这是我继 zerocal 之后的第二个项目,它同样托管在 shuttle 上,整个过程非常顺畅,我很满意。🚀 我们把这个应用叫做 readable:
cargo shuttle init --axum --name readable这会创建一个小型的 Axum 应用,带有一个简单的 hello world 路由。
第一个坑:reqwest
当我把 readability crate 集成到项目中时,遇到了一个小坑。
我像上面那样使用了 extractor::scrape,代理在本地也正常启动了。但当我想要通过代理去抓取一个网站时,却报错了:
thread 'tokio-runtime-worker' panicked at
'Cannot drop a runtime in a context where blocking is not allowed.
This happens when a runtime is dropped from
within an asynchronous context.'
这意味着我在运行时里又启动了一个运行时。
查看 readability crate 的源码后,我发现它构建了一个 reqwest::blocking::Client 并用它来抓取 URL。请求结束后,client 被丢弃,进而导致运行时被关闭。
我通过改用 reqwest::Client 而不是 reqwest::blocking::Client 解决了这个问题。
// reqwest::blocking::Client
let client = reqwest::blocking::Client::new();

// reqwest::Client
let client = reqwest::Client::new();
现在我拿到了文章的内容,但还需要把它传给 readability。好在他们提供了一个名为 extractor::extract 的函数,它接收一个实现了 Read 的对象并返回提取后的内容。
不过,reqwest::Response 并没有实现 Read(与 reqwest::blocking::Response 不同)。所以我需要自己把它转换成可 Read 的类型。
幸运的是,reqwest::Response 有一个 bytes 方法,会返回一个 Bytes 对象。Bytes 对象实现了 Read,我可以用它来调用 extractor::extract。
let body = client.get(&url).await?.text().await?;
let bytes = body.bytes().await?;
let response = extractor::extract(&mut res, &url)?;
第二个坑:路由
应用不再崩溃了,但我依然收不到任何响应。
我的路由是这样的:
#[shuttle_service::main]
async fn axum() -> shuttle_service::ShuttleAxum {
    let router = Router::new().route("/:url", get(readable));
    let sync_wrapper = SyncWrapper::new(router);

    Ok(sync_wrapper)
}
结果发现,当我使用 /:url 作为路由时,它无法匹配 /https://example.com 这样的路径,因为 : 只会匹配到第一个斜杠之前的单个路径段。
解决办法是改用 /*url,这是一个通配符路由,会匹配直到末尾的所有路径段。
排版与布局
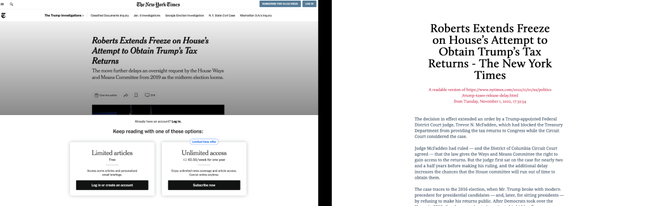
最初的原型我用了一个叫 yue.css 的 CSS 框架,因为这是我找到的第一个看起来不错的框架。
最终版本我模仿了 Ruud van Asseldonk 博客的样式,因为它总让我想起在读一本排版精美的书籍。
字体方面,我选了自己最喜欢的两款
- Crimson Pro 用于正文。
- JetBrains Mono 用于代码。
两者均采用 SIL Open Font License 1.1 授权。
你甚至可以在终端里使用 readable。
lynx https://readable.shuttleapp.rs/https://en.wikipedia.org/wiki/Alan_Turing局限
这个代理远非完美。这只是我花了几个小时为个人使用而搭建的东西。
- 它并不总能生成有效的 HTML。
- 不会执行 JavaScript,所以有些网站无法正常工作。有人可能会说,这算特性而非缺陷。 😉
- 对于带有复杂付费墙或机器人检测的网站也是如此。一种变通办法是使用像 ScrapingBee 或 Browserless 这样的无头浏览器,但我不想为项目增加这种复杂性。
readability库在格式化文档时有很大的自由度,有时会产生奇怪的结果。比如,它特别喜欢把代码块弄得一团糟。
致谢
我不是第一个做 readability 代理的人。做调研时我发现了 readable-proxy,但这个项目似乎已经被废弃了。不过,看到也有其他人有同样的需求,还是挺好的。
感谢 Ruud van Asseldonk 开源了他的博客。🙏 他的写作和文档一直是我重要的灵感来源。
结语
在最流行的浏览器可能会封杀广告拦截器的当下,一个能无广告、无追踪地阅读文章的小服务会派上用场。我并不是说你要把所有流量都经由它转发,但在雨天里,捧着一杯热饮、读一篇好文章时,工具箱里有这样一个小工具还是很不错的。☕
欢迎自行部署一个 readable 实例,或直接使用我托管的那个。源代码已在 GitHub 上开源。也许你们中有人愿意帮我一起维护它。
评论
登录后参与讨论