加速 Rust 编译的技巧
原文由 Matthias Endler 于 发布,订阅该博客
Rust 构建太慢?
下面是一些加快编译速度的技巧。这份清单最初发布在我的个人博客上,后来我决定对其更新并搬到这里。
所有技巧大致按影响大小排序,你可以从头开始依次尝试。
通用技巧
更新 Rust 编译器和工具链
请确保使用最新的 Rust 版本:
rustup update让 Rust 编译器变得更快是一个持续进行的过程。得益于开发团队的努力,今年以来编译速度总体提升了30-40%,部分项目甚至提升了 45% 以上。保持工具链最新是很划算的。
用 cargo check 代替 cargo build
# Slow 🐢
cargo build

# Fast 🐇 (2x-3x speedup)
cargo check大多数时候,你根本不需要完整编译项目,只是想知道自己有没有哪里写错了。只要可能,就完全跳过编译。你真正需要的是极速的代码检查、类型检查和借用检查。
只要可能,就使用 cargo check 而不是 cargo build。它只会检查代码中的错误,而不会生成可执行文件。
对比一下左侧 cargo check 和中间 cargo debug 的指令数量差异。(注意两者刻度不同。)
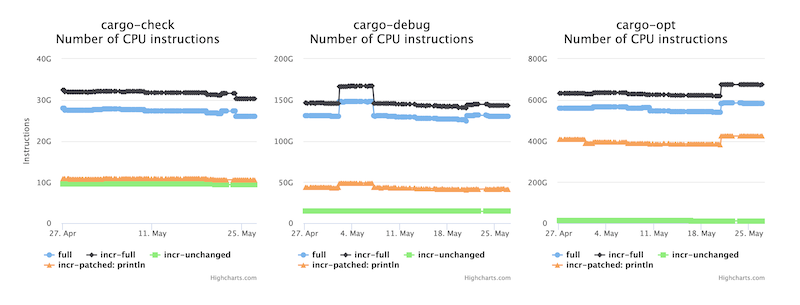
我常用的一个小技巧是配合cargo watch在后台运行。这样每当文件有改动时,就会自动执行 cargo check。
小技巧:使用 cargo watch -c 可在每次运行前清屏。
移除未使用的依赖
# Install cargo-machete 🔪️
cargo install cargo-machete && cargo machete

# Install cargo-shear ✂️🐑
cargo install cargo-shear

# Install cargo-udeps 🧼🧹️
cargo install cargo-udeps --locked
重构之后,有些依赖可能会变得多余。时不时检查一下,看看能否清理掉未使用的依赖是很有帮助的。
上述工具会列出项目中所有未使用的依赖。每个工具都有局限性,可能会出现误报和漏报。三个工具结合使用效果最好。
Analyzing dependencies of crates in this directory...
cargo-machete found the following unused dependencies in <project>:
crate1 -- <project>/Cargo.toml:
        clap
crate2 -- <project>/crate2/Cargo.toml:
        anyhow
        async-once-cell
        dirs
        log
        tracing
url更多信息请查看cargo-machete、cargo-shear和cargo-udeps的项目主页。
感谢读者Nicholas Nethercote提到 cargo-shear 和 cargo-udeps,他是《Rust Performance Book》以及著名的《How to speed up the Rust compiler》系列的作者。
更新依赖
- 运行
cargo update更新到最新的semver兼容版本。 - 运行
cargo outdated -wR查找更新的、可能不兼容的依赖,更新它们并按需修复代码。 - 运行
cargo tree --duplicate查找以多个版本存在的依赖。尽量通过更新依赖来统一到单一版本,以消除重复。(感谢 /u/dbdr指出这一点。)
(以上步骤来自Reddit 上的 /u/oherrala。)
除此之外,还可以使用cargo audit来获取需要处理的安全漏洞或已弃用 crate 的提醒,以便及时替换。
找出代码库中编译最慢的 crate
cargo build --timings它会显示每个 crate 的编译耗时。
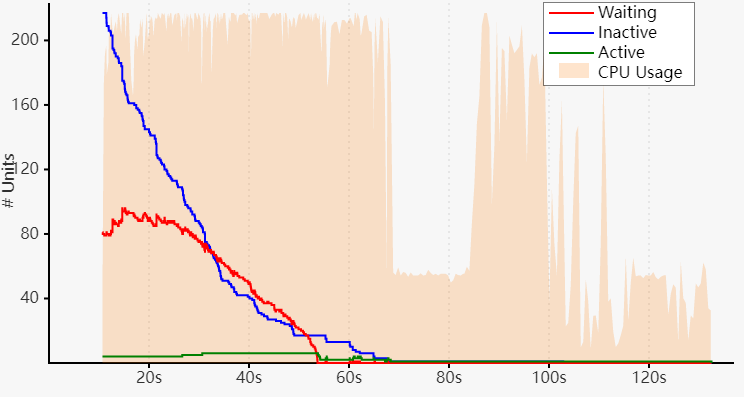
图中红线表示当前等待编译(被其他 crate 阻塞)的单元(crate)数量。如果大量 crate 都卡在同一个 crate 上,就应该重点优化这个 crate 以提升并行度。
各颜色含义:
- Waiting(红色)—— 正在等待 CPU 空位的 crate。
- Inactive(蓝色)—— 等待依赖编译完成的 crate。
- Active(绿色)—— 正在编译中的 crate。
更多信息请参阅文档。
分析编译耗时
如果想比 cargo --timings 挖得更深,可以用cargo rustc -- -Zself-profile来对 Rust 编译过程进行性能分析。生成的 trace 文件可以用火焰图或 Chromium profiler 可视化:
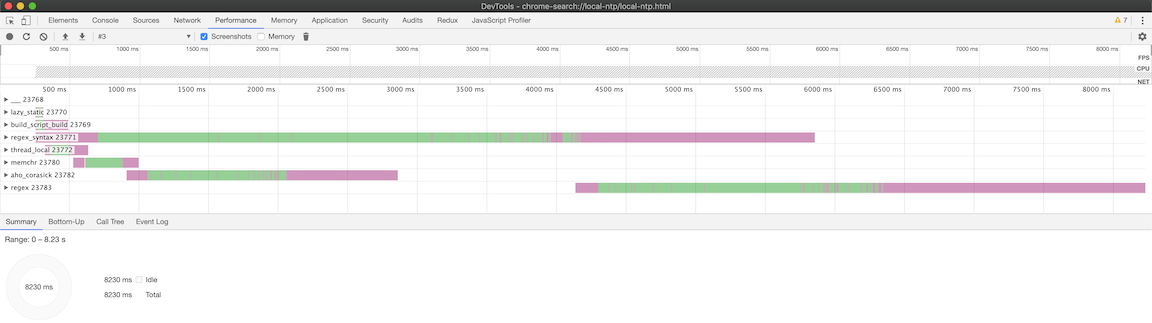
另一个非常好用的工具是cargo-llvm-lines,它会显示最终二进制文件中每个泛型函数生成的行数和拷贝数量,有助于找出编译开销最大的函数。
$ cargo llvm-lines | head -20

  Lines        Copies         Function name
  -----        ------         -------------
  30737 (100%)   1107 (100%)  (TOTAL)
   1395 (4.5%)     83 (7.5%)  core::ptr::drop_in_place
    760 (2.5%)      2 (0.2%)  alloc::slice::merge_sort
    734 (2.4%)      2 (0.2%)  alloc::raw_vec::RawVec<T,A>::reserve_internal
    666 (2.2%)      1 (0.1%)  cargo_llvm_lines::count_lines
    490 (1.6%)      1 (0.1%)  <std::process::Command as cargo_llvm_lines::PipeTo>::pipe_to
    476 (1.5%)      6 (0.5%)  core::result::Result<T,E>::map
    440 (1.4%)      1 (0.1%)  cargo_llvm_lines::read_llvm_ir
    422 (1.4%)      2 (0.2%)  alloc::slice::merge
    399 (1.3%)      4 (0.4%)  alloc::vec::Vec<T>::extend_desugared
    388 (1.3%)      2 (0.2%)  alloc::slice::insert_head
    366 (1.2%)      5 (0.5%)  core::option::Option<T>::map
    304 (1.0%)      6 (0.5%)  alloc::alloc::box_free
    296 (1.0%)      4 (0.4%)  core::result::Result<T,E>::map_err
    295 (1.0%)      1 (0.1%)  cargo_llvm_lines::wrap_args
    291 (0.9%)      1 (0.1%)  core::char::methods::<impl char>::encode_utf8
    286 (0.9%)      1 (0.1%)  cargo_llvm_lines::run_cargo_rustc
    284 (0.9%)      4 (0.4%)  core::option::Option<T>::ok_or_else
排查增量编译缓慢的问题
如果增量编译比预期慢,瓶颈可能出在 rustc 后端对某个 crate 的处理上。
要诊断这个问题,可以结合samply和 -Zhuman_readable_cgu_names=yes 标志来对编译器进行分析,找出编译耗时最长的代码生成单元:
samply record cargo build这能帮你判断某个 crate 是否是构建过程中的最长路径。一旦找到瓶颈,就可以通过重构或拆分该 crate 来改善编译时间。
关于 Rust 编译器后端并行化的更多细节,请参阅Nicholas Nethercote 的博文。
另一个有用的标志是 -Zprint-mono-items=yes,它会在编译期间打印所有单态化项,有助于了解每个 CGU 中生成了什么。
RUSTFLAGS="-Zprint-mono-items=yes" cargo +nightly build ⏎感谢Caspar(Reddit 上的 asparck)提供的这一技巧!
替换重量级依赖
时不时为常用的 crate 寻找更轻量的替代品是很有帮助的。
同样,cargo tree 在这里是你的好帮手,可以帮你了解哪些依赖相当重:它们会引入大量其他 crate,带来过多的网络 I/O 并拖慢构建。找到它们后,再去寻找更轻的替代方案。
另外,cargo-bloat的 --time 标志可以显示每个 crate 的构建时间,非常实用!
下面是几个例子:
| Crate | 替代方案 |
|---|---|
| serde | miniserde, nanoserde |
| reqwest | ureq |
| clap | lexopt |
这里有一个通过更换 crate 将编译时间从 2 分 22 秒缩短到 26 秒的例子。
使用 Workspace 将大 Crate 拆成小 Crate
Cargo 有一个很实用的功能叫workspace,可以把一个大 crate 拆成多个小 crate。这种代码拆分非常有利于避免重复编译,因为只有发生改动的 crate 才需要重新编译。像servo和vector这样的大型项目就大量使用 workspace 来缩短编译时间。
禁用依赖中未使用的 Feature
cargo-features-manager是一个较新的工具,可以帮你禁用依赖中未使用的 feature。
cargo install cargo-features-manager
cargo features prune
时不时检查一下依赖的 feature 标志。很多库作者都会费心把 crate 拆成可按需开关的独立 feature,也许你并不需要每个 crate 的全部默认功能?
例如,tokio 有大量 feature,如果不需要就可以禁用。
另一个例子是 bindgen,它默认为二进制用法启用了 clap 支持,但这在更常见的库用法中并不需要。禁用该 feature使 rust-rocksdb 的 debug 和 release 构建的编译时间分别缩短了约 13 秒和 9 秒。感谢读者Lilian Anatolie Moraru提到这一点。
友情提示
关闭 feature 似乎并不总能提升编译速度。(参见tikv 在此的经验。)但这仍然有助于通过减少代码的攻击面来提升安全性。此外,禁用 feature 还能精简依赖树。
使用 cargo add 安装 crate 时,就能看到它的 feature 列表。
如果想查询某个 crate 的 feature 标志,可以在docs.rs上查看,例如tokio 的 feature 标志。
移除未使用的 feature 后,查看 Cargo.lock 文件的 diff,就能看到被清理掉的所有多余依赖。
为开销大的代码添加 Feature
[features]
# Basic feature for default functionality
default = []

# Optional feature for JSON support
json = ["serde_json"]

# Another optional feature for more expensive or complex code
complex_feature = ["some-expensive-crate"]
项目中并非所有代码的编译开销都一样。你可以使用 Cargo feature 以比 crate 更细的粒度将代码拆成更小的块,这样只需编译你需要的功能。
这在库中很常见。例如,serde 有一个名为 derive 的 feature,用于启用序列化和反序列化的代码生成,它并非总是需要,因此默认是关闭的。同样,Tokio 和 reqwest 也有大量可按需启用的 feature。
你也可以在自己的代码中这样做。在上面的例子中,Cargo.toml 里的 json feature 启用了 JSON 支持,而 complex_feature 则启用了另一条开销较大的代码路径。
查找触发重新构建的根本原因
有时即使代码没有改动,很多 crate 也会重新构建,这通常是由于不同构建过程之间的环境变量差异造成的(比如 Makefile 构建、rust-analyzer 和 CI 构建之间的差异)。
可以使用 cargo 的指纹日志来精确定位触发重新构建的原因:
export CARGO_LOG="cargo::core::compiler::fingerprint=info"
export RUST_LOG=trace
cargo build -vv
查找显示重建原因的行,例如:
INFO prepare_target: cargo::core::compiler::fingerprint: dirty: EnvVarChanged { name: "VIRTUAL_ENV", old_value: None, new_value: Some("/path/to/.venv") }

Dirty pyo3-build-config v0.24.1: the env variable VIRTUAL_ENV changed
看到那行“Dirty”了吗?它会精确告诉你是什么导致了重新构建。你可以用 grep 搜索这一行来找出所有重建原因。
常见的罪魁祸首包括:
- 环境变量(CC、CXX、VIRTUAL_ENV、PATH 的变化)
- 不同构建工具之间的 feature 标志不一致
- 使用了不同的 cargo profile
- 生成文件的时间戳差异
找到原因后,要确保所有构建过程保持一致。对于 VS Code 中的 rust-analyzer,你可以在 .vscode/settings.json 中配置一致的环境变量:
{
  "rust-analyzer.check.extraEnv": {
    "CC": "clang",
    "CXX": "clang++",
    "VIRTUAL_ENV": "/path/to/your/.venv"
  },
  "rust-analyzer.cargo.features": "all"
}
当不同工具使用不一致的环境时,这种调试方法可以大幅减少不必要的重新构建。
致谢:这一技巧出自Ishan Bhanuka的这篇文章。
使用 sccache 缓存依赖
另一个不错的项目是 Mozilla 的sccache,它会缓存已编译的 crate 以避免重复编译。
我在笔记本上跑过一段时间,说实话收益相当有限。它最适合的场景是你同时处理大量共享相同版本依赖的独立项目,典型的用例是共享构建服务器。
Cranelift:替代的 Rust 编译器
你知道吗,Rust 项目在每次 CI 构建中都会并行运行一个替代编译器来与 rustc 对比?
rustc_codegen_cranelift,也被称为 CG_CLIF,是一个基于Cranelift编译器框架的 Rust 编译器实验性后端。
下图是 rustc 和 Cranelift 在一些热门 crate 上的对比(蓝色表示更优):
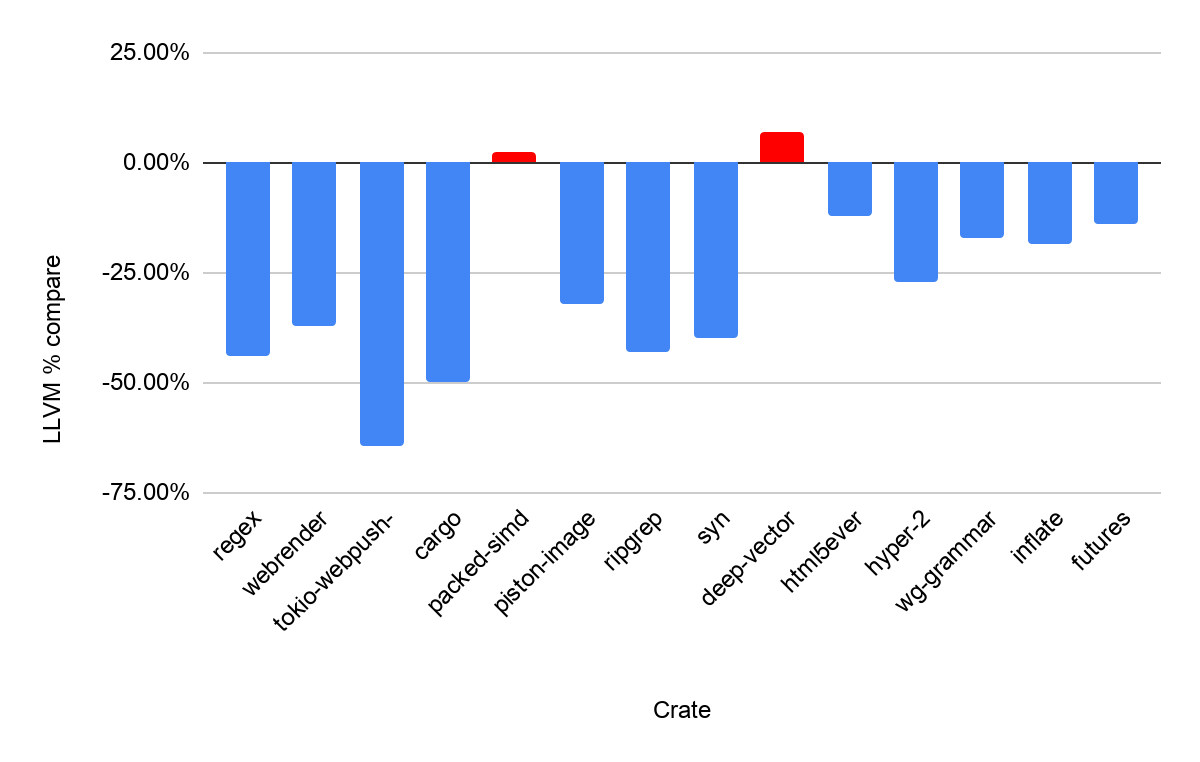
该编译器能生成完全可用的可执行文件。虽然优化程度不如正式版,但非常适合本地开发。
更详细的介绍请看Jason Williams 的文章,项目代码在GitHub 上。
切换到更快的链接器
什么是链接器?
链接器是将多个目标文件合并为单个可执行文件的工具。
它是编译过程的最后一步。
你可以通过运行以下命令来检查链接器是否是瓶颈:
cargo clean
cargo +nightly rustc --bin <your_binary_name> -- -Z time-passes
它会输出每个步骤的耗时,包括链接时间:
...
time:   0.000   llvm_dump_timing_file
time:   0.001   serialize_work_products
time:   0.002   incr_comp_finalize_session_directory
time:   0.004   link_binary_check_files_are_writeable
time:   0.614   run_linker
time:   0.000   link_binary_remove_temps
time:   0.620   link_binary
time:   0.622   link_crate
time:   0.757   link
time:   3.836   total
    Finished dev [unoptimized + debuginfo] target(s) in 42.75s
如果 link 步骤很慢,可以尝试切换到更快的替代方案:
| 链接器 | 平台 | 可用于生产 | 说明 |
|---|---|---|---|
lld | Linux/macOS | 是 | 系统链接器的直接替代品 |
mold | Linux | 是 | 针对 Linux 优化 |
zld | macOS | 否(已弃用) | Apple ld 链接器的直接替代品 |
仅 macOS:更快的增量 Debug 构建
Rust 1.51 为 macOS 添加了一个加快增量 debug 构建的标志。根据使用场景,它可以让 debug 构建快上数秒。一些工程师报告称,仅这一个标志就将 macOS 上的编译时间缩短了70%。
将以下内容添加到你的 Cargo.toml 中:
[profile.dev]
split-debuginfo = "unpacked"
该标志可能很快会成为 macOS 的默认设置,在 nightly 上已经是默认值。
仅 macOS:将 Rust 编译排除在 Gatekeeper 之外
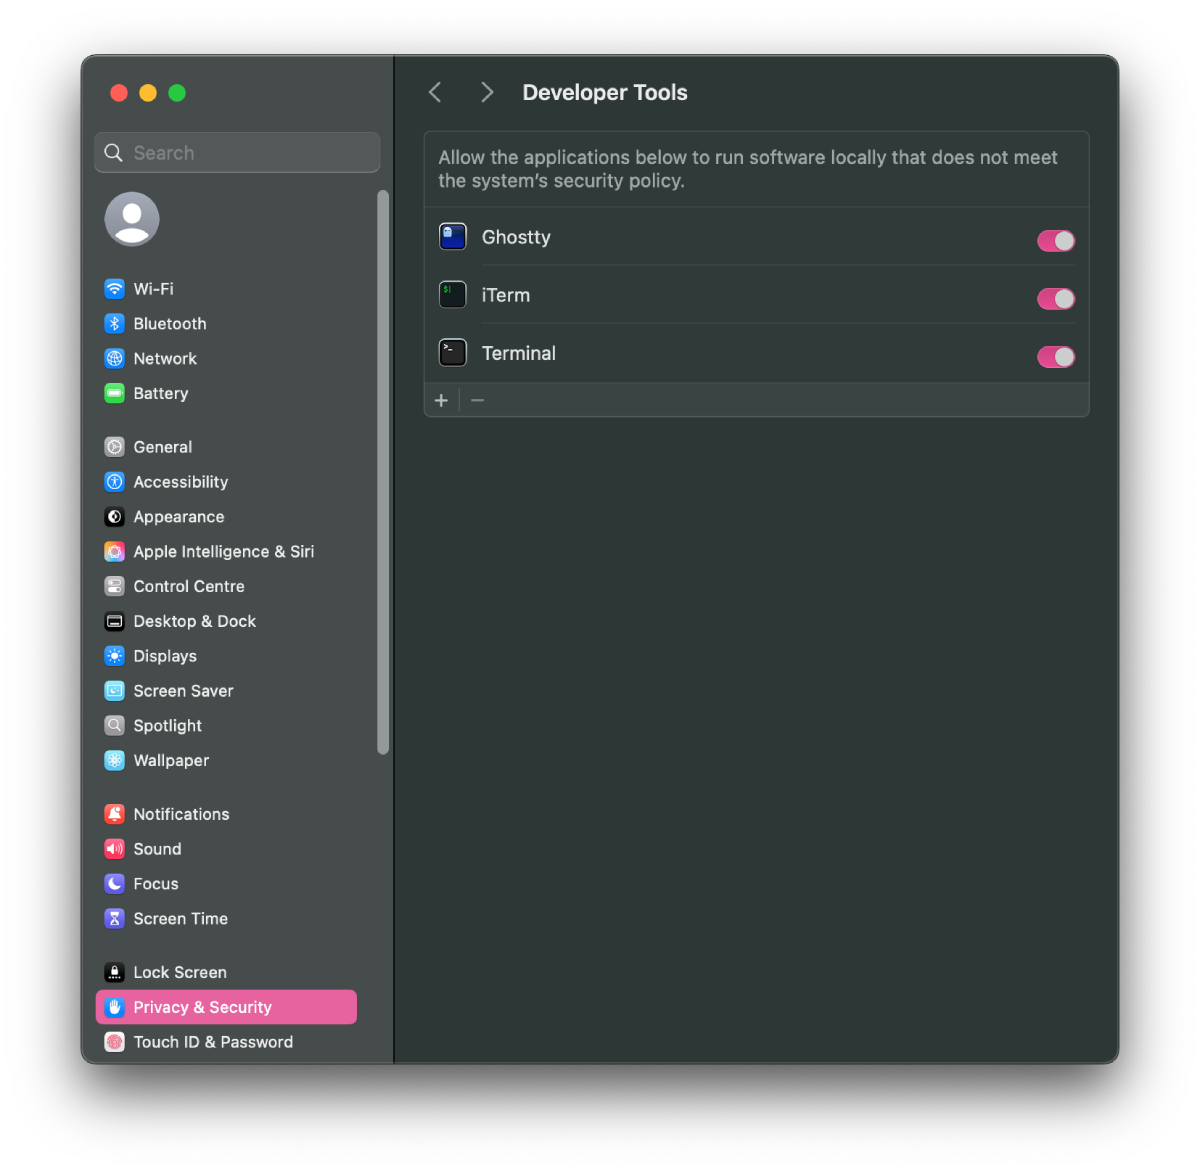
Gatekeeper 是 macOS 上对二进制文件进行安全检查的系统,它会让每次 Rust 构建慢上几秒。解决方法是将你的终端添加到开发者工具中,这样由它启动的进程就会被排除在 Gatekeeper 检查之外。
- 在终端中运行
sudo spctl developer-mode enable-terminal。 - 打开系统偏好设置,进入安全性与隐私。
- 在隐私标签页中,进入
Developer Tools。 - 确保你的终端已在列表中并已启用。如果你使用 iTerm 或 Ghostty 等第三方终端,也请一并添加。
- 重启终端。
仅 Windows:为 Rust 配置 Dev Drive
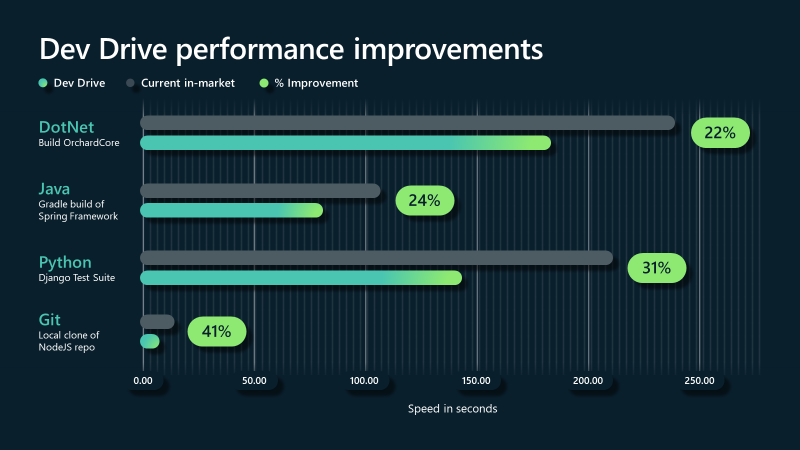
Windows 11 包含了Dev Drive,这是一种为开发优化的文件系统。据微软称,使用 Dev Drive 可获得约 20-30% 的速度提升:
要提升 Rust 编译速度,请将以下内容移到 Dev Drive:
- Rust 工具链文件夹(
CARGO_HOME) - 你的项目代码
- Cargo 的
target目录
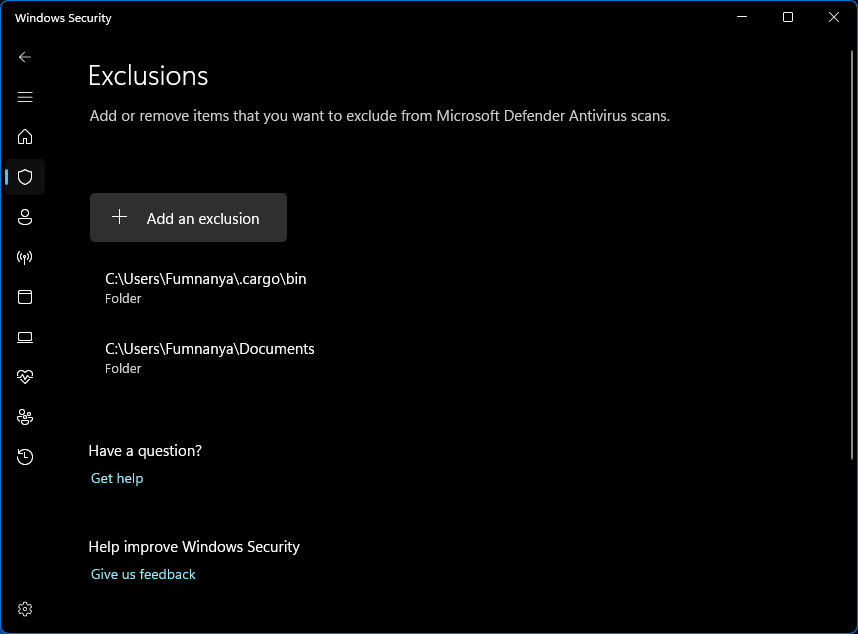
你还可以更进一步,将上述文件夹添加到杀毒软件的排除列表中,以获得进一步的加速。你可以在 Windows 安全中心的“病毒和威胁防护设置”中找到排除设置。
感谢nextest 团队提供的技巧。
调整 Codegen 选项和编译器标志
Rust 提供了大量代码生成设置,浏览列表并为你的项目调整参数会很有帮助。
在完整的 codegen 选项列表中有许多宝藏可挖。作为参考,这里是bevy 为加快编译而使用的配置。
避免过程宏 Crate
如果你的项目大量使用了过程宏(例如使用了 serde),可以尝试在 Cargo.toml 中调整 opt-level。
[profile.dev.build-override]
opt-level = 3正如读者jfmontanaro在GitHub上提到的:
我认为这能帮助缩短构建时间的原因在于,它只作用于构建脚本和过程宏。构建脚本和过程宏比较特殊,因为在常规构建中,它们不仅会被编译,还会被执行(而过程宏可能会被反复执行)。当项目大量使用过程宏时,对宏本身进行优化理论上可以节省不少时间。
另一种思路是使用watt来规避宏对编译时间的影响,这是一个将宏编译 offload 到 WebAssembly 的工具。
摘自文档:
通过将宏提前编译为 Wasm,我们让所有下游的宏使用者无需再自行编译宏逻辑及其依赖。
相反,他们只需编译一个小而自包含的 Wasm 运行时(约 3 秒,由所有宏共享)和每个宏 crate 的一个微小过程宏 shim,用于将 Wasm 字节码交给 Watt 运行时(每个依赖的过程宏 crate 约 0.3 秒)。这远少于编译复杂过程宏及其依赖可能需要的 20 多秒。
请注意,该 crate 仍处于实验阶段。
找出开销大的过程宏
RUSTFLAGS="-Zmacro-stats" cargo +nightly build有些宏的编译开销很大,但到底有多大?量化这些开销有助于判断某个宏是否值得优化(或移除)。一种方法是了解它们到底生成了多少代码。
一种方法是使用 cargo expand 查看生成的代码,但在大型代码库中这种方法难以扩展,且输出难以量化。
另一种方法是使用 -Zmacro-stats 标志来识别生成大量代码的过程宏。该工具已经帮助Bevy和Arbitrary等项目实现了成功的优化。
更多信息,请阅读Nicholas Nethercote 关于该主题的博文。
针对过程宏的条件编译
过程宏需要解析 Rust 代码,这是一项相对复杂的任务。依赖过程宏的 crate 必须等待过程宏编译完成后才能开始编译。例如,serde 可能会成为编译时间的瓶颈并限制 CPU 利用率。
为了改善 Rust 的编译时间,可以考虑更策略性地处理 Serde 序列化,尤其是在采用共享 crate 结构的项目中。与其在项目各处共用的共享 crate 中直接引入 Serde,不如通过 Cargo feature 将 Serde 设为可选依赖。
使用 cfg 或 cfg_attr 属性,让共享 crate 中对 Serde 的使用和 derive 受 feature 控制。这样它就成了仅在真正需要序列化/反序列化的叶子 crate 中才启用的可选依赖。
这种做法可以避免整个项目都等待 Serde 依赖编译完成——如果 Serde 作为非可选的直接依赖放在共享 crate 中,就会发生这种情况。
我们用一个简化的例子来说明。假设你有一个 Rust 项目,包含一个共享库 crate 和若干依赖它的其他 crate。你不希望在构建不需要 Serde 的部分时还去编译它。
下面展示如何通过 Cargo 的可选 feature 来组织项目:
在共享 crate 的 Cargo.toml 中,将 serde 声明为可选依赖:
[package]
name = "shared"
version = "0.1.0"
edition = "2021"

[dependencies]
serde = { version = "1.0", optional = true }
在此 crate 中,使用条件编译,仅在启用该 feature 时才引入 serde:
#[cfg(feature = "serde")]
use serde::{Serialize, Deserialize};

#[cfg_attr(feature = "serde", derive(Serialize, Deserialize))]
pub struct MySharedStruct {
    // Your struct fields
}
在其他 crate 中,如果需要,就为共享 crate 启用 serde feature:
[package]
name = "other"
version = "0.1.0"
edition = "2021"

[dependencies]
shared = { path = "../shared", features = ["serde"] }
现在,你可以在需要的地方以启用 Serde 功能的方式使用 MySharedStruct,而不会让不需要它的 crate 的编译变得臃肿。
泛型:使用内部非泛型函数
如果你有一个泛型函数,它会针对你使用的每种类型都编译一次。如果类型很多,这就会成为问题。
常见的解决方法是使用一个内部的非泛型函数。这样编译器只需编译一次内部函数。
这是标准库中常用的技巧。例如,下面是read_to_string的实现:
pub fn read_to_string<P: AsRef<Path>>(path: P) -> io::Result<String> {
    fn inner(path: &Path) -> io::Result<String> {
        let mut file = File::open(path)?;
        let size = file.metadata().map(|m| m.len() as usize).ok();
        let mut string = String::with_capacity(size.unwrap_or(0));
        io::default_read_to_string(&mut file, &mut string, size)?;
        Ok(string)
    }
    inner(path.as_ref())
}
你也可以在自己的代码中这样做:外层函数是泛型的,而它调用执行实际工作的内层非泛型函数。
使用 cargo-hakari 改善 Workspace 构建时间
你的大型 Rust workspace 是否存在这样的依赖:
- 被多个 crate 使用
- 在不同 crate 中启用了不同的 feature 集合?
这种情况会导致构建时间变长,因为 cargo 会根据正在构建的 crate,以不同的 feature 多次构建同一个依赖。这时cargo-hakari就派上用场了,它是一个用于自动管理“workspace-hack” crate 的工具。
在某些场景下,它可以将连续构建时间缩短多达 50% 甚至更多。想了解更多,请查看官方 cargo-hakari 文档中的使用说明和基准测试。
使用动态库加速 Rust 增量编译
# Install the tool
cargo install cargo-add-dynamic

# Add a dynamic library to your project
cargo add-dynamic polars --features csv-file,lazy,list,describe,rows,fmt,strings,temporal
这会在 polars 之外创建一个包装 crate,并将其编译为动态库(Linux 上为 .so,macOS 上为 .dylib,Windows 上为 .dll)。
本质上,它是用以下配置来 patch 该依赖:
[lib]
crate-type = ["dylib"]
利用这个技巧,当你只改动自己的代码时,就可以省去依赖的链接时间。依赖本身只有在你更改 feature 或版本时才会重新编译。当然,这对任何 crate 都有效,不限于 polars。
更多内容请阅读Robert Krahn 的这篇博文和该工具的主页。
切换到新的并行编译器前端
在 nightly 版本中,你现在可以启用新的并行编译器前端。要尝试它,请使用 -Z threads=8 选项运行 nightly 编译器:
RUSTFLAGS="-Z threads=8" cargo +nightly build如果你觉得效果不错,可以通过在 ~/.cargo/config.toml 文件中添加 -Z threads=8 将其设为默认:
[build]
rustflags = ["-Z", "threads=8"]
或者,你也可以在 shell 配置文件(如 ~/.bashrc 或 ~/.zshrc)中为 cargo 设置别名:
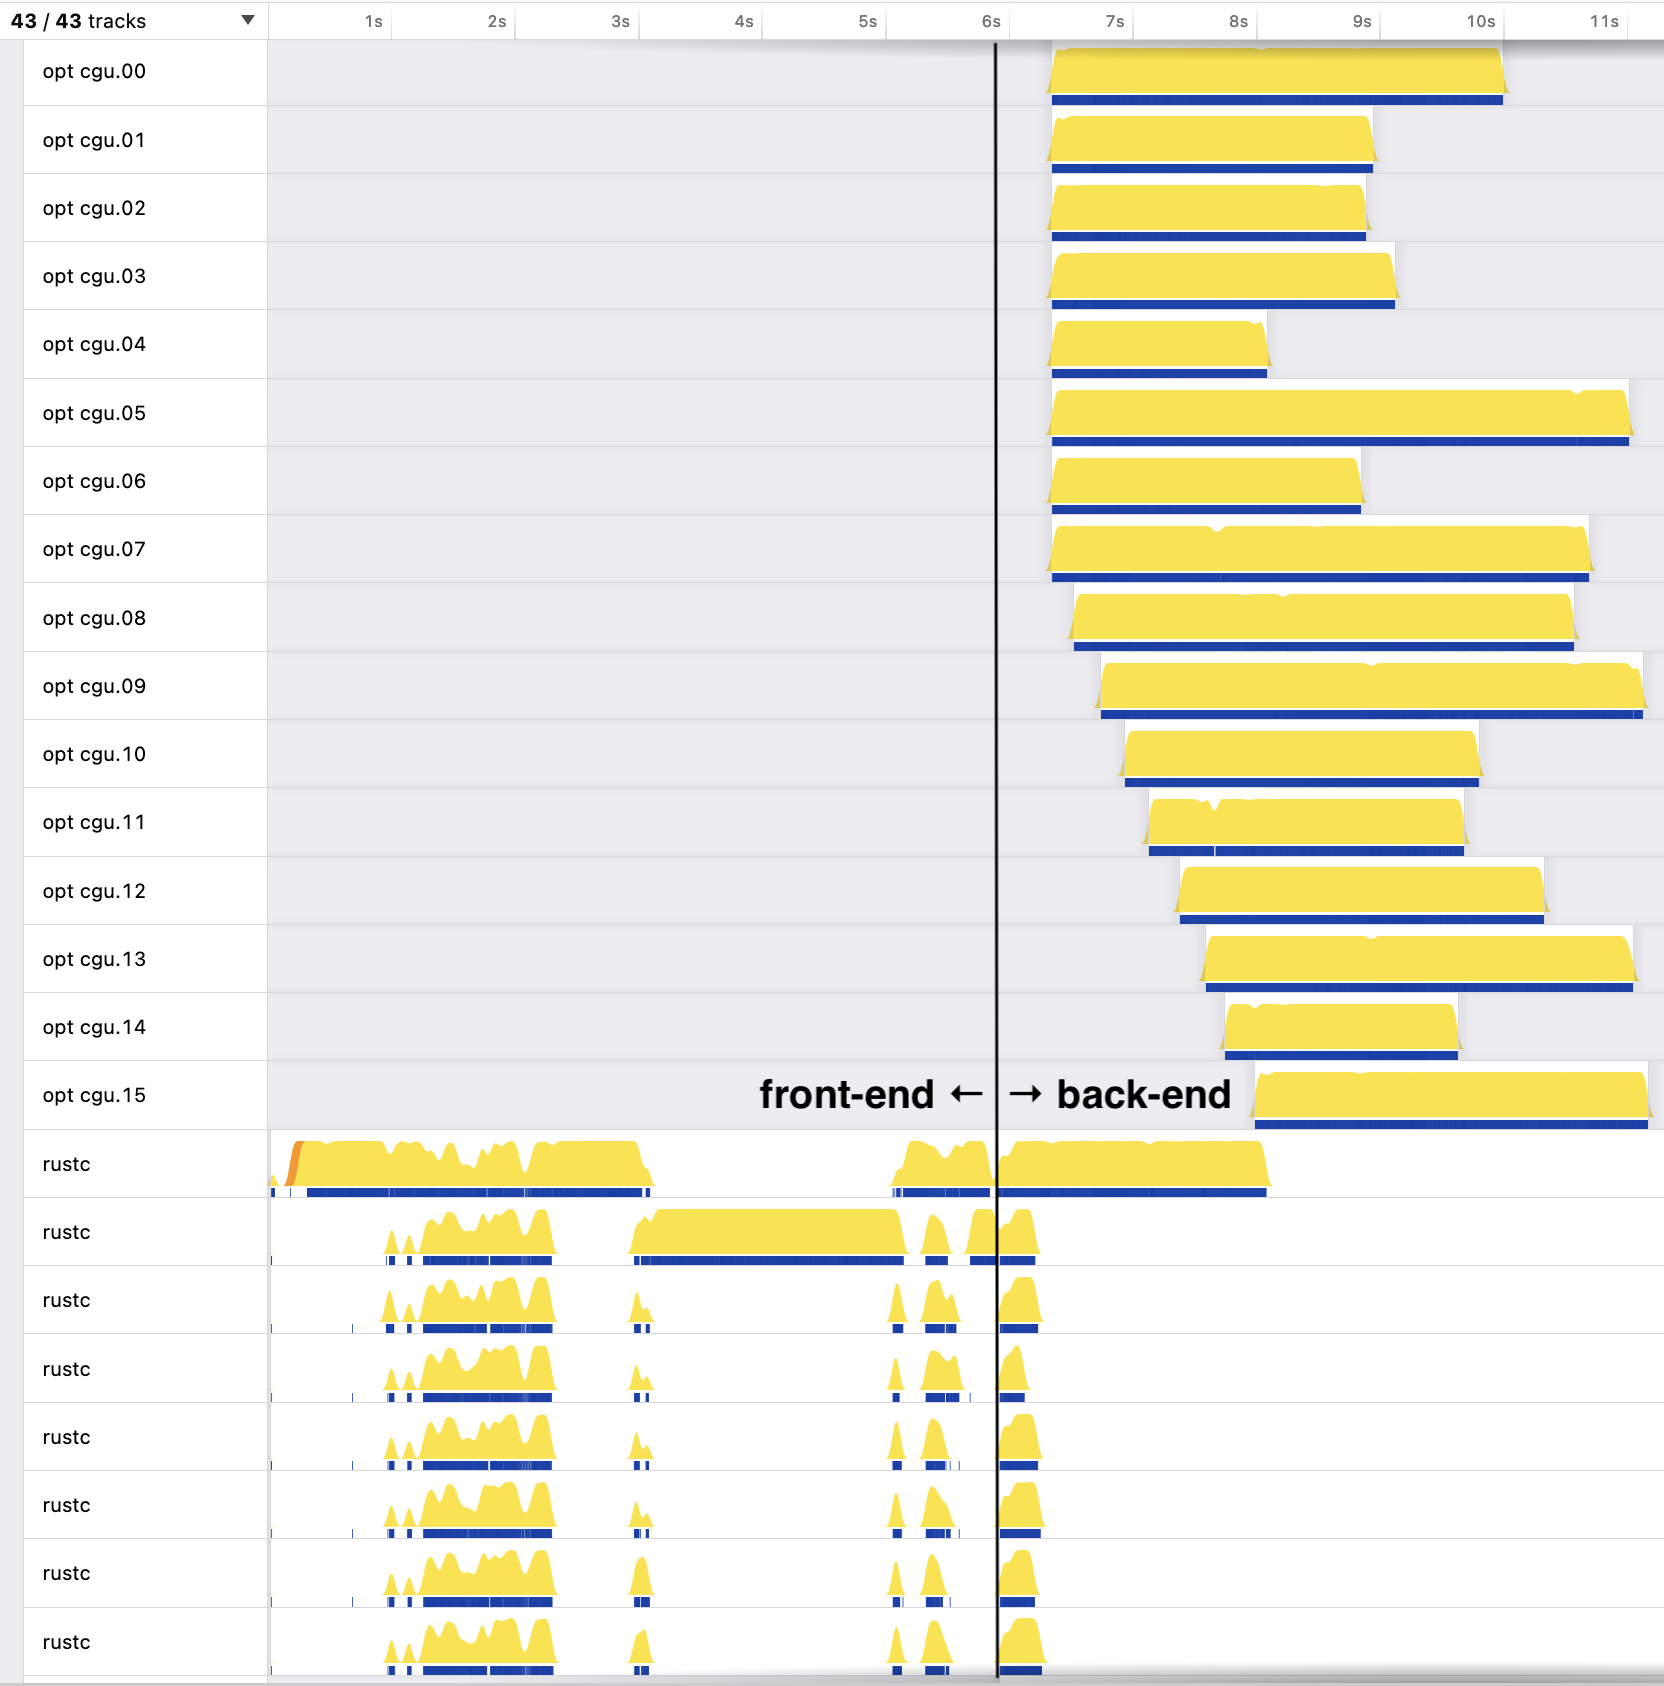
alias cargo="RUSTFLAGS='-Z threads=8' cargo +nightly"当使用 -Z threads=8 在多线程环境下执行前端时,对真实代码的基准测试表明编译时间最多可缩短50%。不过,提升幅度会因被编译的代码而异。尽管如此,仍然值得一试。
下图是并行编译器前端运行时的可视化效果:
更多信息请查看Rust 官方博客上的公告。
使用临时磁盘加快构建
文件系统可能是瓶颈。可以考虑为构建目录使用内存文件系统。
传统的临时文件系统如 tmpfs 受限于内存加交换空间的大小,对于会产生大量中间产物的构建来说可能会有问题。
在 Linux 上,可以改用以下选项挂载 ext4 卷:
-o noauto_da_alloc,data=writeback,lazytime,journal_async_commit,commit=999,nobarrier如果内存足够,这会将文件保存在页缓存中,稍后再回写。请将其视为临时文件系统,因为在崩溃或断电后数据可能会丢失或损坏。
投资更好的硬件
如果你已经看到这里,进一步提升编译速度最简单的方法可能就是花钱买顶级硬件了。
就笔记本而言,苹果新款 MacBook 的 M 系列 芯片在 Rust 编译方面表现非常出色。
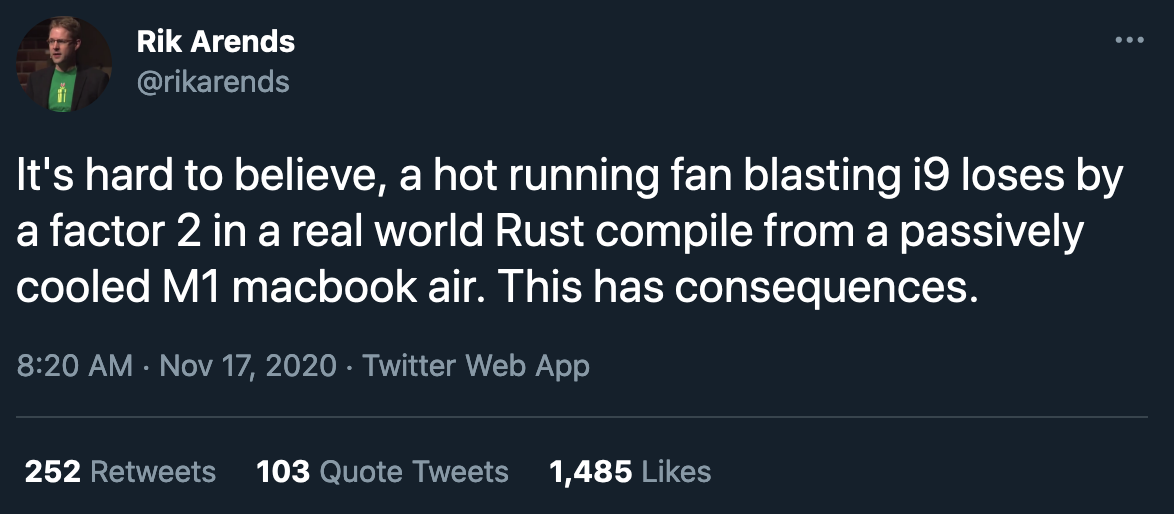
M1 Max 版 MacBook Pro 的基准测试结果简直离谱——即使与已经很快的 M1 相比也是如此:
| 项目 | M1 Max | M1 Air |
|---|---|---|
| Deno | 6m11s | 11m15s |
| MeiliSearch | 1m28s | 3m36s |
| bat | 43s | 1m23s |
| hyperfine | 23s | 42s |
| ripgrep | 16s | 37s |
这是实打实的 2 倍性能提升。
但如果你更倾向于使用 Linux,像AMD Ryzen Threadripper 搭配 32GB 内存这样的多核 CPU 也有人取得了很好的效果。
在便携设备上编译既耗电又慢。为了避免这个问题,我把家里的那台 6 核 AMD FX 6300、12GB 内存的机器当作构建机,配合Visual Studio Code Remote Development使用。
在云端编译
如果你自己没有专用机器,也可以将编译过程放到云端。GitHub Codespaces在 GitHub 内为你提供了一个完全配置好的云端开发环境。你可以点击Code按钮并选择Open with Codespaces,从任意仓库启动一个 codespace。机器规格从 2 核到 32 核不等,每个 GitHub 账户每月都有一定的免费额度(目前在 2 核机器上为 60 小时)。
Codespaces 通过 .devcontainer/devcontainer.json 文件支持开发容器配置,你可以预先安装 Rust 工具链和其他依赖,让环境在启动时就已就绪。这在审查拉取请求时特别有用——直接在 codespace 中打开 PR,一切都已配置完毕。
如果你想对构建环境有更多控制,Northflank是另一个选择。它允许你在专用的云基础设施上运行任意构建任务,方案从共享的 0.1 vCPU 容器到 32 个专用 vCPU 不等。它提供免费的沙盒套餐,付费方案按秒计费,你只需为实际的构建时间付费。
在本地缓存所有 Crate
如果你的网络较慢,初次构建的很大一部分时间会花在从 crates.io 拉取各种 crate 上。为了缓解这个问题,你可以预先下载所有 crate 到本地缓存。criner就是做这个的:
git clone https://github.com/the-lean-crate/criner
cd criner
cargo run --release -- mine归档大小出乎意料地合理,截至目前大约需要50GB 磁盘空间。
测试执行
使用 Cargo Nextest 替代 cargo test
cargo install cargo-nextest
cargo nextest run
cargo 自带了一个小型的测试运行器,这很好,但特别是当你需要构建多个测试二进制文件时,得益于其并行执行模型,cargo nextest可以比 cargo test 快多达 60%。下面是一些简要的基准测试:
| 项目 | 版本 | 测试数量 | cargo test (秒) | nextest (秒) | 提升 |
|---|---|---|---|---|---|
| crucible | cb228c2b | 483 | 5.14 | 1.52 | 3.38× |
| guppy | 2cc51b41 | 271 | 6.42 | 2.80 | 2.29× |
| mdBook | 0079184c | 199 | 3.85 | 1.66 | 2.31× |
| meilisearch | bfb1f927 | 721 | 57.04 | 28.99 | 1.96× |
| omicron | e7949cd1 | 619 | 444.08 | 202.50 | 2.19× |
| penumbra | 4ecd94cc | 144 | 125.38 | 90.96 | 1.37× |
| reqwest | 3459b894 | 113 | 5.57 | 2.26 | 2.48× |
| ring | 450ada28 | 179 | 13.12 | 9.40 | 1.39× |
| tokio | 1f50c571 | 1138 | 24.27 | 11.60 | 2.09× |
将所有集成测试合并为单个二进制文件
有集成测试吗?(就是放在 tests 文件夹中的那些。)你知道 Rust 编译器会为每个测试都创建一个二进制文件吗?而且每个二进制文件都必须单独链接。这可能会占据你大部分的构建时间,因为链接非常慢。🐢 原因是许多系统链接器(如 ld)是单线程的。
为了让链接器的工作轻松一些,你可以把所有测试放在一个 crate 中。(基本上就是在测试文件夹中创建一个 main.rs,然后把测试文件作为 mod 加进去。)
这样链接器就只需构建一个二进制文件。听起来不错,但要注意:这仍然是一种权衡,因为你需要将内部类型和函数暴露出来(即设为 pub)。
如果你有很多集成测试,这可以带来 50% 的加速。
本技巧由Luca Palmieri、Lucio Franco和Azriel Hoh提供,感谢!
将慢速测试放到环境变量后面
#[test]
fn completion_works_with_real_standard_library() {
  if std::env::var("RUN_SLOW_TESTS").is_err() {
    return;
  }
  ...
}
如果你有运行缓慢的测试,可以将它们放到环境变量后面,默认禁用。这样你可以在本地跳过它们,只在 CI 上运行。
(这个小技巧是我从matklad(Alex Kladov)的文章中学到的。)
CI 构建
CI 构建技巧
本文中的许多技巧同样适用于 CI 构建。关于针对 CI 的优化和最佳实践,请查看我的专门指南《更快的 CI 构建技巧》,其中涵盖了缓存策略、工作流优化以及针对 GitHub Actions 的改进。
为依赖使用缓存
特别是对于 GitHub Actions,你还可以使用Swatinem/rust-cache。
只需在工作流中添加一步即可:
jobs:
  test:
    runs-on: ubuntu-latest
    steps:
      - uses: actions/checkout@v4
      - uses: dtolnay/rust-toolchain@stable
      - uses: Swatinem/rust-cache@v2
      - run: cargo test --all
这样,你的依赖就会在构建之间被缓存,可以期待显著的加速。
拆分编译和测试步骤
- name: Compile
  run: cargo test --no-run --locked

- name: Test
  run: cargo test -- --nocapture --quiet
这样更容易分清有多少时间花在编译上,有多少花在运行测试上。
在 CI 中禁用增量编译
env:
  CARGO_INCREMENTAL: 0
由于 CI 构建更接近于从零开始的构建,增量编译会带来不必要的依赖跟踪和 I/O 开销,降低缓存效果。这里是禁用方法。
关闭 Debuginfo
[profile.dev]
debug = 0
strip = "debuginfo"
避免链接调试信息可以加快构建过程,特别是当你很少使用真正的调试器时。有两种方式可以避免链接调试信息:设置 debug=0 来跳过编译,或设置 strip="debuginfo" 来跳过链接。遗憾的是,更改这些选项可能会触发 Cargo 的全量重建。
- 在 Linux 上,两者都设置以获得更好的构建时间。
- 在 Mac 上,使用
debug=0,因为 rustc 使用外部的 strip 命令。 - 在 Windows 上,两种设置都试试,看哪种更快。
请注意,没有调试信息时,回溯只会显示函数名,而不会显示行号。如有需要,可以使用 split-debuginfo="unpacked" 作为折中方案。
一个额外的好处是,这还有助于减小 ./target 的体积,提高缓存效率。
这里有一个配置示例,展示如何应用这些设置。
通过环境变量拒绝警告
避免在代码中使用 #![deny(warnings)],以免重复声明。此外,在本地开发期间出现警告是完全可以接受的。
相反,可以将 -D warnings 添加到 RUSTFLAGS,以在 CI 上全局拒绝所有 crate 中的警告。
env:
  RUSTFLAGS: -D warnings
切换到更快的 GitHub Actions Runner
- runs-on: ubuntu-latest
+ runs-on: ubicloud像Ubicloud、BuildJet或RunsOn这样的服务为你的 GitHub Actions 构建提供了更快的执行器。特别是对于 Rust 流水线,核心数量对编译时间有非常大的影响,因此值得一试。
下面是使用 Ubicloud 的Facebook Folly项目的例子。虽然这是一个 C++ 项目,但它展示了更快执行器的潜力:

注册该服务后,你只需在 GitHub Actions 工作流文件中更改 runner 即可。
更快的 Docker 构建
使用 cargo-chef 加速 Docker 构建
在用 Rust 代码构建 Docker 镜像吗?这个过程可能非常慢,因为 cargo 尚不支持仅构建项目的依赖,如果不注意,每次构建都会使 Docker 缓存失效。cargo-chef来救场了!⚡
cargo-chef可以充分利用 Docker 层缓存,从而大幅加快 Rust 项目的 Docker 构建速度。在我们的商业代码库(约 1.4 万行代码、约 500 个依赖)上,我们测得5 倍加速:Docker 构建时间从约 10 分钟缩短到约 2 分钟。
如果你感兴趣,这里有一个 Dockerfile 示例:
# Step 1: Compute a recipe file
FROM rust as planner
WORKDIR app
RUN cargo install cargo-chef
COPY . .
RUN cargo chef prepare --recipe-path recipe.json

# Step 2: Cache project dependencies
FROM rust as cacher
WORKDIR app
RUN cargo install cargo-chef
COPY --from=planner /app/recipe.json recipe.json
RUN cargo chef cook --release --recipe-path recipe.json

# Step 3: Build the binary
FROM rust as builder
WORKDIR app
COPY . .
# Copy over the cached dependencies from above
COPY --from=cacher /app/target target
COPY --from=cacher /usr/local/cargo /usr/local/cargo
RUN cargo build --release --bin app

# Step 4:
# Create a tiny output image.
# It only contains our final binary.
FROM rust as runtime
WORKDIR app
COPY --from=builder /app/target/release/app /usr/local/bin
ENTRYPOINT ["/usr/local/bin/app"]cargo-chef还可以帮助你通过 GitHub Actions 加速持续集成,或加速部署到 Google Cloud 的过程。
考虑使用 Earthly 获得更好的构建缓存
Earthly 是一个相对较新的构建工具,旨在替代 Makefile、Dockerfile 和其他构建工具。它为 CI 提供了快速的增量 Rust 构建。
Earthly 通过有效实现 Cargo 的缓存和 Rust 的增量编译来加速 CI 中的 Rust 构建。这种方法显著减少了 CI 中不必要的重建,复现了本地 Rust 构建的效率。
他们使用一种名为 Satellite 的系统,即持久化的远程构建执行器,会在本地保留缓存数据。这通过消除缓存的上传和下载,可以大幅加快 CI 构建时间。他们不是把缓存数据搬到计算节点,而是让缓存数据与计算同地部署,彻底消除了缓存传输。更少的 I/O 意味着更快的构建。
Earthly 还提供了一个 lib/rust 库,完全抽象掉了缓存配置。它确保 Rust 在 CI 中能够正确缓存并增量构建。你可以在Earthfile中这样使用它:
IMPORT github.com/earthly/lib/rust如果你感兴趣,Earthly 的 Rust 指南中详细介绍了一个带有优化缓存和编译步骤的简单 Rust 示例。
针对 IDE 的优化
如果你发现开发环境中的构建时间很慢,这里还有一些可以尝试的额外技巧。
Visual Studio Code 中调试会话缓慢
如果你使用 Visual Studio Code 并发现调试会话很慢,请确保没有设置过多断点。每个断点都可能拖慢调试会话。
关闭不相关的项目
如果你在 Visual Studio Code 中打开了多个项目,每个实例都会运行一份独立的 rust-analyzer,这可能会拖慢你的机器。如果不需要,请关闭不相关的项目。
修复 Rust Analyzer 缓存失效问题
如果你在 VS Code 中使用 rust-analyzer,并发现保存改动时构建很慢,可能是缓存失效了。这也会导致像 serde 这样的依赖被频繁重建。
你可以通过为 rust-analyzer 配置单独的目标目录来解决这个问题。将其添加到 VS Code 设置中(最好是用户设置):
{
    "rust-analyzer.cargo.targetDir": true
}
这样 rust-analyzer 就会在 target/rust-analyzer 而不是默认的 target/ 目录中构建,从而避免与常规的 cargo run 构建相互干扰。
一些用户报告称因此获得了显著的加速:
before: 34.98s user 2.02s system 122% cpu 30.176 total
after: 2.62s user 0.60s system 84% cpu 3.803 total这也可能有助于解决rust-analyzer 阻塞 debug 构建的问题。
致谢:本技巧由Reddit 上的 asparck分享。
总结
在本文中,我们涵盖了大量内容。我们探讨了如何通过使用更好的硬件、优化代码和使用更高效的工具来加快 Rust 构建。
关于针对 CI 的优化,别忘了查看《更快的 CI 构建技巧》,它是对本文所讨论技巧的补充。
希望这些技巧中有些能帮你加快 Rust 的构建速度。如果你找到了其他加速 Rust 构建的方法,或有任何问题与反馈,欢迎告诉我。
更多资源
更快的 CI 构建技巧 - 我收集的加快 CI 构建的技巧。
The Rust Perf Book中关于编译时间的章节。
8 Solutions for Troubleshooting Your Rust Build Times是 Dotan Nahum 写的一篇很棒的文章,我完全赞同。
通过提升 30%来改进大型 Rust 项目的构建时间(lemmy)。
arewefastyet(已离线)用于衡量 Rust 编译器编译常见 Rust 程序所需的时间。
Speeding up the Rust edit-build-run cycle:一种以基准测试为驱动的改进 Rust 编译时间的方法。
评论
登录后参与讨论