微前端中的缓存与 CDN
原文由 Alex O'Callaghan 于 发布,订阅该博客
在微前端架构中处理缓存要比在单体前端中复杂得多。系统中包含外壳应用、多个远程清单以及它们所引用的代码分片,每一部分的发布节奏不同,对内容过期程度的容忍度也不一样。本文将介绍我们在 Mintel 是如何处理这个问题的,过去遇到过哪些故障,以及目前仍未完全解决的难点。
更新于 2026 年 6 月:我后续又写了一篇关于优化微前端缓存策略的文章,介绍了我们为提升性能、降低带宽成本所做的改动。
我们的技术栈
我们使用 Webpack Module Federation 运行着约 30 个微前端。外壳应用是一个纯静态的 Jamstack 应用,部署在 S3 上,通过 CloudFront 提供服务,最外层则由 Akamai 统一代理。各个远程应用都位于固定且众所周知的 URL 上。
部署只需一条 rclone 命令,即可将构建好的 dist 目录复制到 S3 上每个微前端对应的子目录中。外壳应用和各个远程应用都是独立部署的,由不同的团队分别维护。
如何为不同类型的资源配置缓存
不同资源的缓存需求各不相同。下面是我们目前的配置及原因。
index.html —— no-cache
外壳应用的 index.html 负责启动整个应用。一旦它过期,后续的一切都可能出错。我们通过 S3 对象元数据为它设置 Cache-Control: no-cache 响应头,这一过程在部署时自动完成。
no-cache 并不意味着文件不会被缓存。它的意思是 CDN 或浏览器在提供缓存内容前,必须先向源站进行校验。如果源站返回 304,则使用缓存副本;如果内容已发生变化,则返回最新的文件。
remoteEntry.js —— 永不缓存
remoteEntry.js 是 Module Federation 的清单文件。它告诉外壳应用去哪里加载某个远程应用的代码分片。当你部署一个远程应用时,这个文件的内容会变,但文件名保持不变。
过期的 remoteEntry.js 会导致两种故障。一种是显性的错误:如果它指向的是上一次部署产生的、已被替换的代码分片,就会出现运行时错误。另一种则更为隐蔽:用户迟迟拿不到新版本的应用。远程团队明明已经发布了修复或新功能,但由于清单文件过期,用户仍在运行旧代码。
在 Akamai 层,我们为 remoteEntry.js 设置了 Cache-Control: no-store, max-age=0,从而阻止浏览器缓存它。我们还通过 module-federation-import-remote 这个包实现了动态远程加载,它默认会在 remoteEntry.js 的 URL 后追加一个用于破坏缓存的查询参数。由于我们的 CloudFront 分发会将查询字符串纳入缓存键,这就确保了即使文件在 CloudFront 上已被缓存,每次请求也会因为 URL 唯一而绕过缓存,直接从 S3 获取最新版本。
代码分片(Chunks)—— 不设置显式缓存头
remoteEntry.js 所引用的 JS 代码分片通过 Webpack 的 contenthash 占位符实现了内容寻址。当文件内容发生变化时,哈希值会改变,文件名也随之改变。这意味着你可以对这些分片进行激进的缓存——新版本部署时会产生全新的文件名,CDN 会自动将其视为全新资源。
在 output.filename 中配置这一点非常简单:
output: {
  filename: '[name].[contenthash].js',
}
我们也遇到过团队忘记为远程应用的资源文件名配置 contenthash 的情况。分片以可预测的文件名部署后被缓存,后续的部署直到缓存 TTL 自然过期后才对用户生效。
目前我们没有为代码分片设置显式的 Cache-Control 头。CloudFront 会根据 S3 返回的 Last-Modified 或 ETag 头推算出一个启发式 TTL 来缓存这些文件。在 Akamai 层,我们对源站响应设置了 no-store 策略,因此所有的缓存实际上只发生在浏览器或 CloudFront 上。
404 处理
我们的外壳应用是一个单页应用,路由在客户端完成。如果用户直接访问某个路由或刷新页面,CDN 会在 S3 上查找对应路径的文件,找不到时默认会返回 404。
解决方法是在 CloudFront 中配置:当源站返回 4xx 时,改回 index.html。AWS 在 CloudFront 分发设置中将这一功能称为自定义错误响应。
Akamai 会将所有不匹配已知 API 或 MPA 路由的请求都代理到 CloudFront,因此这一回退逻辑在 CloudFront 层处理,并对所有微前端路由生效。
用户请求流程
远程应用采用懒加载,通过 React.lazy 和动态 import 包装。只有当用户导航到需要某个远程应用的页面时,外壳应用才会去拉取对应的 remoteEntry.js。
CloudFront / S3 故障
上述架构是随着时间逐步演进而来的,一定程度上也是对线上故障的回应。2025 年 1 月,AWS 出现的一次故障导致我们的 CloudFront 源站无法从 S3 拉取内容,返回了 404 NoSuchBucket 错误。由于 CloudFront 已配置为对来自 S3 的 4xx 响应返回 index.html——这是单页应用常见的兜底配置——这些错误在到达 Akamai 之前就被转换成了 200 响应。Akamai 无法感知到异常,照常将其缓存。等到 AWS 恢复后,用户仍会从 Akamai 边缘节点和本地浏览器缓存中拿到这些错误的缓存响应。
在 Akamai 上做缓存清除既慢又痛苦。你无法通过通配符批量清除匹配某个模式的所有路径,必须提供具体的 URL。面对数十个微前端和数百个 JS 分片文件,在紧急情况下这根本不现实。我们最后只能进入紧急作战室,手忙脚乱地提交清除请求,看着请求一直在加载,缓存则在接下来几个小时里随着 TTL 自然过期才慢慢失效。而且,这对那些已在浏览器中缓存了错误响应的用户也无济于事。
我们最后想到的应急办法,是在几个核心微前端的 Webpack 配置中修改 contenthash 的长度,然后重新部署。改变 contenthash 长度会让所有生成的文件名都发生变化,从而迫使 CDN 将其视为全新资源,而不是继续提供缓存的错误响应。这个办法奏效了,但它是在高压下临时想出来的,并不是预案文档中的标准操作。
自那以后,我们禁用了 Akamai 对微前端资源的缓存,并为 S3 存储桶增加了多地域容灾,以降低再次陷入同样困境的风险。我们也开始为 index.html 显式设置 no-cache,确保变更能被快速感知,错误的回退响应也不会被长期缓存。
坦白说,对于“如果再次出现错误响应被缓存该怎么办”这个问题,我们目前仍然没有一个干净利落的解决方案。修改 contenthash 长度这一技巧,依然是我们需要在短时间内全量失效时的“核选项”,用它来强制生成全新的文件名。
改进缓存策略
写这篇文章的过程,也是对现有缓存策略的一次有益梳理。当系统运行正常时,缓存配置往往不会被经常回顾,而目前这套方案在实践中也基本够用。
不过,我们的缓存配置分散在多处:index.html 依赖 S3 对象元数据,remoteEntry.js 依赖 Akamai 规则,而其他资源则完全没有显式的缓存头。没有一个地方能完整地看到全貌。我们目前在最外层的 Akamai 上完全不做缓存,这是对之前故障痛苦经历的强烈反应,但这也损害了性能并增加了带宽成本。
更清晰的做法是,在源站通过 S3 对象元数据为每种资源类型显式设置 Cache-Control 头,并将各层 CDN 视为遵循源站头信息的缓存,而不是定义缓存策略的地方。这样一来,即便将来替换或重新配置 Akamai 层,缓存行为也会跟随源站,而不会被悄然丢失。
我们目前完全没有为代码分片设置缓存头,只能依赖 CDN 和浏览器的启发式策略来决定缓存时长。为带 contenthash 的分片显式设置 Cache-Control: max-age=31536000, immutable,并让 Akamai 重新遵循源站缓存头,将是一个不错的改进,能确保它们作为不可变资源被积极且正确地缓存——但以我们现有的架构,无法保证每个团队都已正确地将构建产物的文件名配置为使用 contenthash。不过,倒是存在另一种能同时解决这两个问题的方案,只是它需要更大幅度的架构调整。
另一种方案:带版本的 URL 与发现服务
以上所有方案都假设远程应用位于固定且众所周知的 URL 上。这是最简单的部署模型,但也正是 remoteEntry.js 难以缓存的根本原因——因为当你在原地覆写同一个文件时,你永远无法安全地对其进行长期缓存。
更稳健的做法是在 URL 本身中加入版本信息:
https://cdn.example.com/remote-a/v1.4.2/remoteEntry.js使用带版本的路径后,remoteEntry.js 就和其它代码分片一样成为了内容寻址的文件。你可以用 max-age=31536000, immutable 来缓存它。旧版本会一直在 S3 中保留,因此正在使用中的用户不会因为一次部署而中断。回滚也只需将清单指向之前的版本,而无需重新部署。
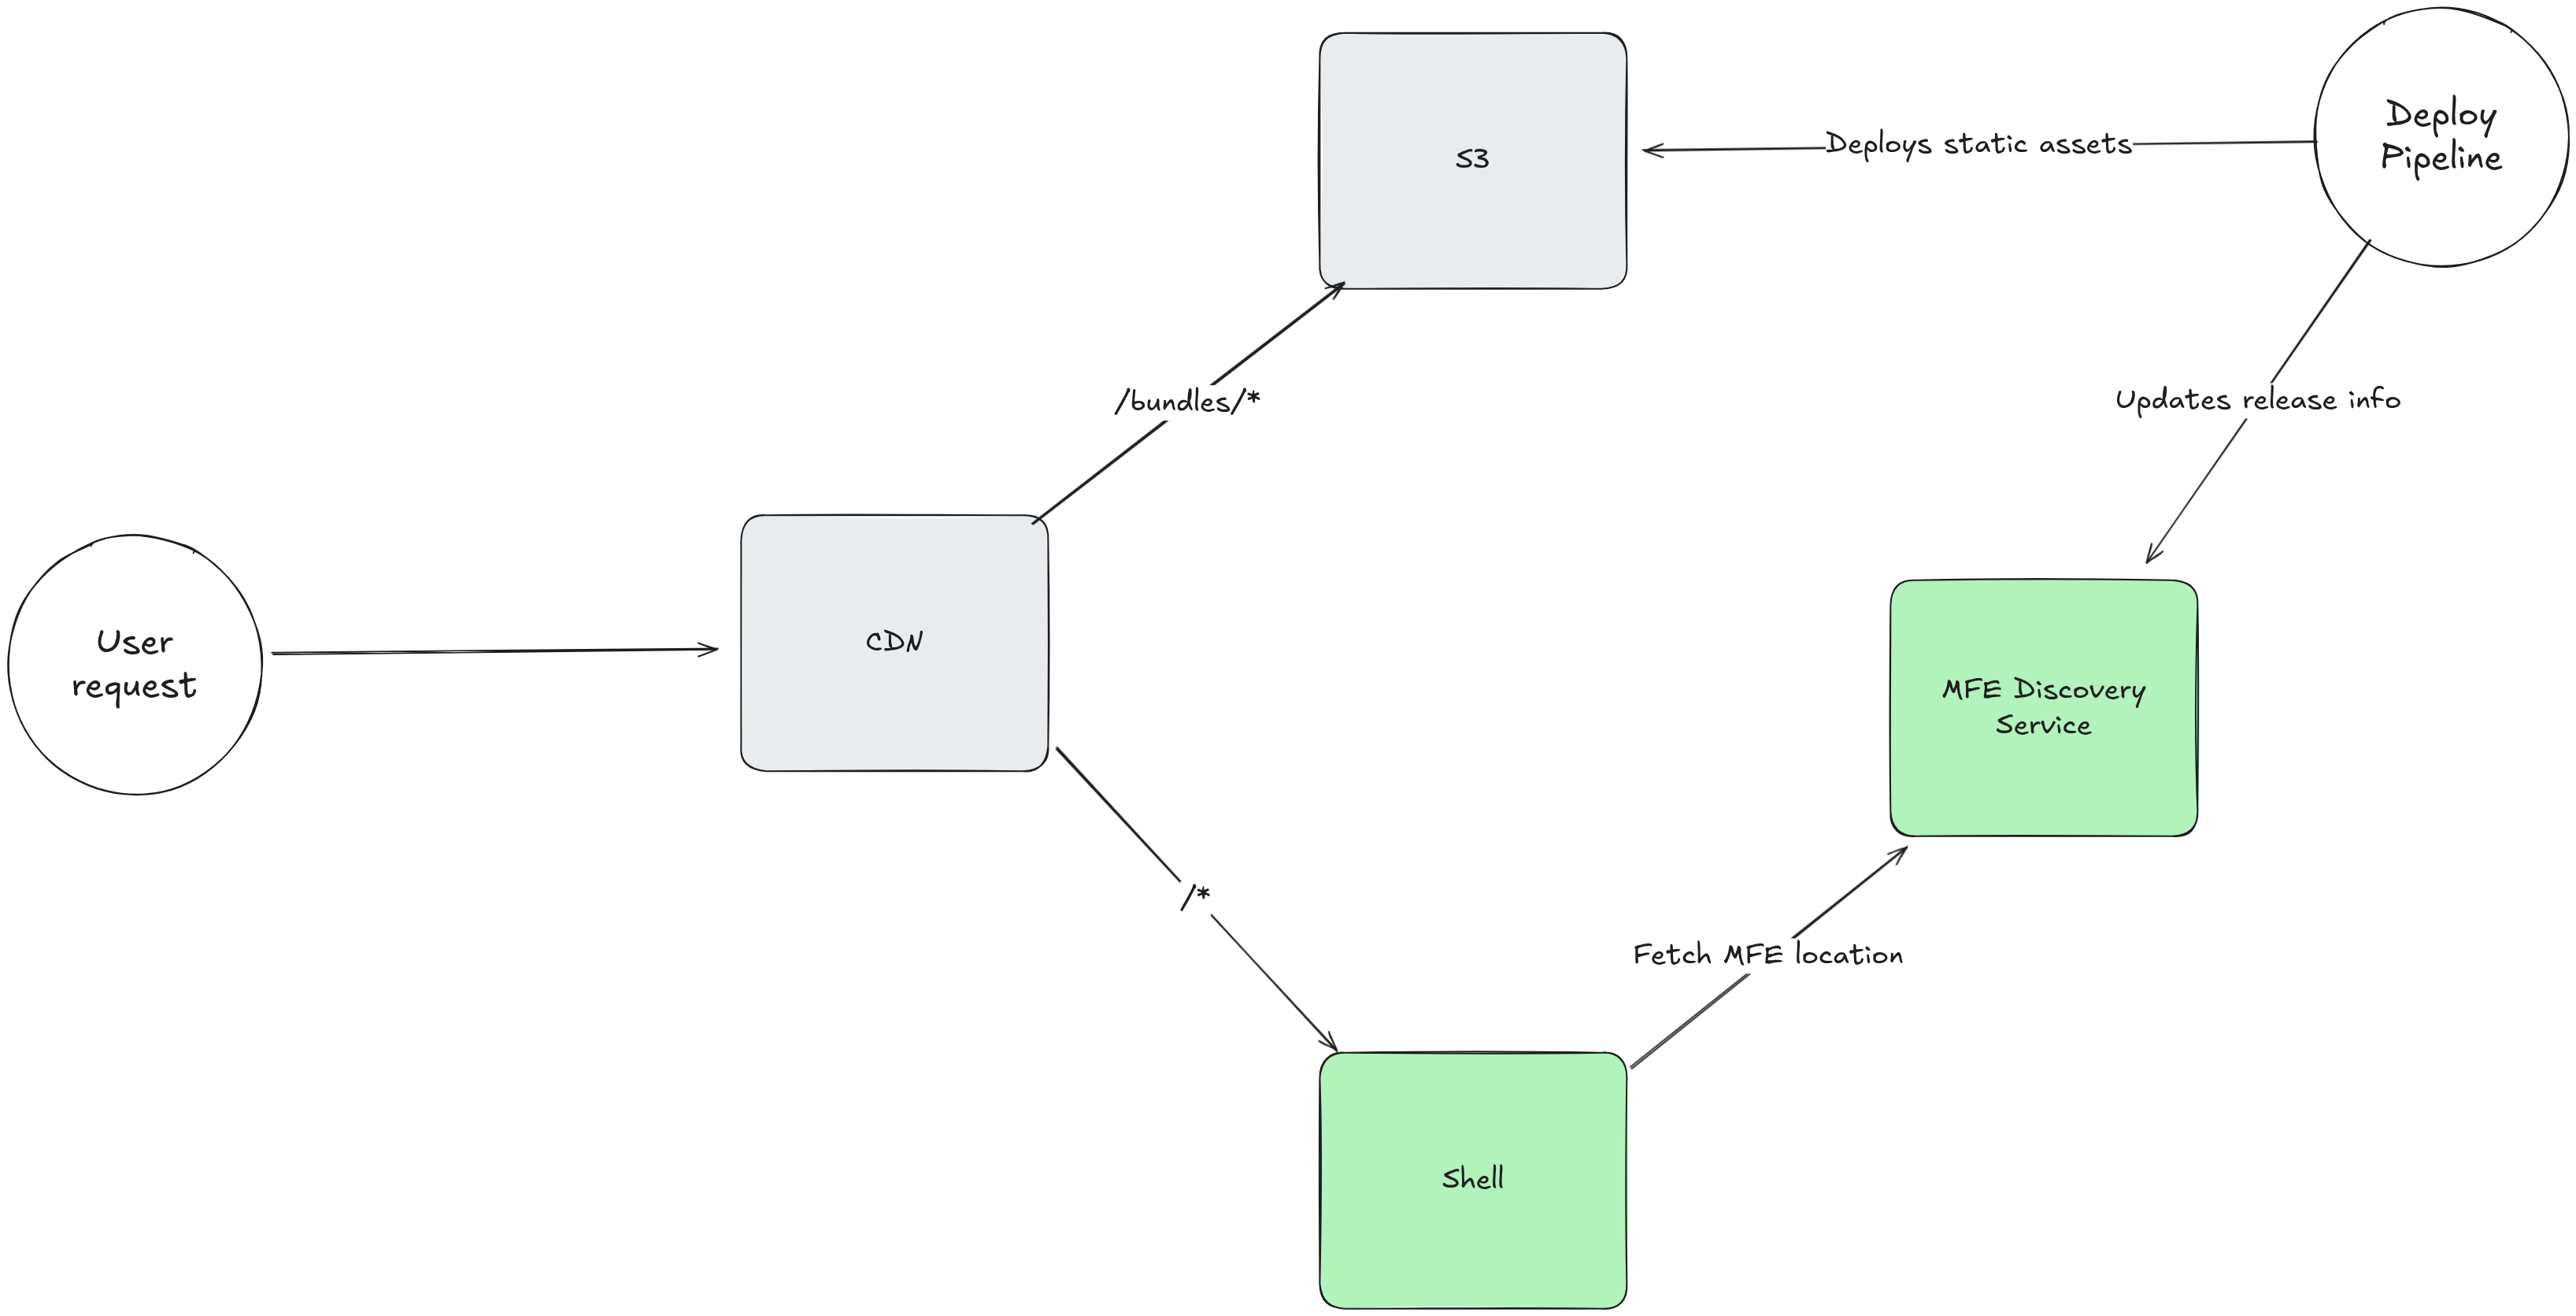
要实现这一点,外壳应用就不能硬编码远程应用的 URL。你需要一个发现服务——外壳在启动时会调用它来获取每个远程应用的当前 URL:
{
  "remote-a": "https://cdn.example.com/remote-a/v1.4.2/remoteEntry.js",
  "remote-b": "https://cdn.example.com/remote-b/v2.1.0/remoteEntry.js"
}
不过,我们目前并没有采用这种方式,尽管一年多前我们就已经识别出这一模式,并将其作为可能的未来方向写入了架构蓝图。它固然能兜住那些忘记配置 contenthash 的团队,但这本质上是规范执行的问题,并不足以成为迁移 30 个微前端的理由。在每一层 CDN 上做更积极的缓存也确实有助于提升性能、降低带宽成本,尽管如果不深入分析缓存命中率和带宽成本,很难量化其具体影响;而且通过现有方案为分片设置 immutable 头,也能达到类似的效果。
引入发现服务还能支持更复杂的部署模式,比如金丝雀发布或在部署层面的功能开关,但这都会增加复杂度和运维负担。大多数情况下,我们能够直接在应用逻辑内部实现功能开关,这样更容易弄清楚用户实际运行的是哪部分代码。金丝雀发布要真正发挥作用,也需要在自动化监控和告警策略上投入时间。
虽然发现服务仍是一个潜在的未来选项,但我们更近期的重点,还是在现有相对简单的部署模式下,持续改进当前的缓存策略。
评论
登录后参与讨论