修復我的 Golang 網頁應用程式中的記憶體耗盡錯誤
原文由 Michael Lynch 于 發布,訂閱此部落格
今年稍早,我建立了一個名為 PicoShare 的開源應用程式。它是一個用來分享檔案的簡單 Golang 網頁應用程式。我用它來傳送那些太大、無法作為電子郵件附件的檔案,但又不想讓收件人去處理 Dropbox 或 Google Drive。
幾個月前,我發現我的 PicoShare 伺服器每隔幾天就會掛掉。查看紀錄後,我看到了記憶體不足的錯誤:

我當時沒時間除錯,所以只是把伺服器的記憶體從 512 MB 加到 1 GB。後來還是持續當機,我又再加到 2 GB。
用加大記憶體來解決當機問題,實在讓人很不踏實,所以過去兩週我一直在除錯,並在 Twitter 上分享我的進度。
到目前為止,我已經修復了所有導致當機的問題,也在過程中學到了關於 Go、SQLite 和除錯的寶貴經驗。
如果你想看整個過程是如何展開的,可以去看那則 Twitter 討論串。如果你想看整理過、精簡後的重點,請繼續往下讀。
前言:我對 SQLite 的奇怪用法
我在設計 PicoShare 時做了一個奇怪的架構決定:把所有檔案資料都存進 SQLite。這是個不尋常的選擇,因為網頁應用程式通常會把上傳的檔案直接存在檔案系統上,而不是資料庫裡。尤其是當上傳的檔案可能任意大的時候更是如此。
把檔案資料寫進 SQLite 的好處是,PicoShare 所有的應用程式狀態都在單一資料庫裡。這本身沒什麼特別,但我設計 PicoShare 時讓它能與 Litestream 整合,這是一套能把 SQLite 資料庫複製到雲端儲存空間的工具。Litestream 等於免費為 PicoShare 提供了備份與還原功能。就算我把整台伺服器砍掉重來,然後在任何地方重新部署(甚至換一家雲端主機商),PicoShare 也能以完全相同的狀態醒來,繼續提供原本的所有檔案。
除錯過程
重現錯誤
我只有每隔幾天才會看到 PicoShare 當機,所以第一步就是想辦法讓它更快當掉。
我設法重現錯誤的方法,是在只有 256 MB 記憶體的 Fly 機器上部署 PicoShare,然後上傳大型檔案。我使用了短片Big Buck Bunny 的高解析度版本,檔案大小從 269 MB 到 618 MB 不等。

我用短片 Big Buck Bunny 作為測試檔案,因為它夠大,適合用來測試大檔上傳。
同時平行上傳兩個 618 MB 的版本,就能在大約一分鐘內穩定地讓 PicoShare 因記憶體不足而掛掉。
使用效能分析工具找出記憶體膨脹
調查的第一個突破來自 Ben Johnson,他是 Litestream 的作者,也是最近加入 Fly 團隊的成員。Ben 建立了一個詳細的 pull request,說明單一一行程式碼如何導致 PicoShare 消耗大量記憶體。
Ben 在效能分析方面經驗豐富,所以他透過新增一個單元測試並在測試後分析記憶體來重現問題。Ben 後來還教了我一個更簡單的方法來取得相同資訊,我接下來會介紹這個方法,但你也可以在他的 pull request 中找到他原本的做法。
結果發現,Go 標準函式庫本身就有一個用來除錯網頁應用程式的神奇工具。你只需要在 import 中加入這一行:
_ "net/http/pprof"接著當你執行應用程式時,就會多出一個 /debug/pprof/ 路徑,裡面有許多實用的除錯資訊。

我很驚訝這竟然這麼容易就能加上去。這個網頁介面中有很多有趣的資料,但我用到的是 heap。用法是先上傳一個大檔到 PicoShare,然後執行以下指令:
go tool pprof \
  -http=:8081 \
  -alloc_space \
  call_tree \
  http://localhost:4001/debug/pprof/heap
接著就會跳出一個網頁介面,並畫出這張圖:

在底部可以看到一個標示為 bytes makeSlice 63.99 MB 的大紅色區塊,意思是 PicoShare 已配置的記憶體中有 64 MB 來自 Go 的 makeSlice 函式。
makeSlice 是 Go 標準函式庫的一部分,不是我的程式碼。為了找出是 PicoShare 的哪段程式碼導致這次記憶體配置,我沿著圖表往上追溯,直到找到 PicoShare 的函式:

這條呼叫鏈中最後一個 PicoShare 函式是 handlers.fileFromRequest,它呼叫了 Go 標準函式庫的 *Request.ParseMultipartForm。這個函式負責解析 multipart HTTP 資料,也就是 PicoShare 接收檔案上傳的方式。
ParseMultipartForm 接受一個 maxMemory 參數,文件說明如下:
整個請求主體會被解析,其中最多有 maxMemory 位元組的檔案部分會被儲存在記憶體中,其餘部分則會以暫存檔的形式儲存在磁碟上。
PicoShare 的呼叫長這樣:
r.ParseMultipartForm(32 << 20) // 32 MB即使我們指定了 32 MB 的上限,Go 還是配置了 64 MB 的記憶體。
Ben 嘗試把 maxMemory 參數降到 1 << 20(1 MB),結果來自 ParseMultipartForm 的記憶體使用量降到只有 2.5 MB:

這是記憶體使用量的大幅下降,所以我一度以為 Ben 已經解決問題了。
可惜,我部署了包含 Ben 修正的測試版本後,還是當掉了。
套用 Ben 的修正後,PicoShare 在當機前能承受更大的負載,所以看起來確實有改善。但當我同時平行上傳三個大檔時,伺服器還是以同樣的記憶體不足錯誤掛掉。
在呼叫 ParseMultipartForm 後釋放資源
透過 Google 搜尋,我發現了 ParseMultipartForm 的另一個陷阱。
文件沒有警告讀者,但呼叫者有責任呼叫 r.MultipartForm.RemoveAll() 來釋放在 ParseMultipartForm 期間配置的資源。所以,我每次呼叫 ParseMultipartForm 都在洩漏記憶體。
更新(2022-08-11):Damien Neil 在留言中指出,Go 理應會自動清理這些資源。在 Go 的 HTTP/1 實作中,它會自動清理資源,而 Damien 已經提交了修正,讓 Go 的 HTTP/2 實作行為保持一致。
為了修復這個洩漏,我重寫了程式碼來清理 multipart 資源:
multipartMaxMemory := 1 << 20 // 1 MiB
if err := r.ParseMultipartForm(multipartMaxMemory); err != nil {
  return err
}
// Free form resources before returning from function.
defer func() {
  if err := r.MultipartForm.RemoveAll(); err != nil {
    log.Printf("failed to free multipart form resources: %v", err)
  }
}()
這個修正看起來很有希望,因為在明確釋放資源後,我在 Fly 上看到記憶體使用量大幅下降:

遺憾的是,即使有了這個修正,當機還是持續發生。
最佳化下載
這時,Dan Wilhelm 開始關注這則 Twitter 討論串。雖然他一天 Go 都沒寫過,還是捲起袖子,在自己的開發機器上開始實驗程式碼。
Dan 發現下載檔案時記憶體使用量會飆升。這很奇怪,因為下載應該不會消耗太多記憶體。解析 multipart 表單很複雜,有很多因素可能導致記憶體膨脹,但提供檔案下載應該是相當單純的事。
PicoShare 把所有檔案資料都以 328 KB 的區塊儲存在 SQLite 中。這不應該會很耗記憶體,因為我們應該只要讀取一些區塊到記憶體、傳給客戶端,然後釋放記憶體就好。
Dan 在負責從資料庫讀取 PicoShare 檔案資料的程式碼中找到一個錯誤。看看你能不能找出來:
func (fr *fileReader) populateBuffer() error {
  if fr.offset == int64(fr.fileLength) {
    return io.EOF
  }

  startChunk := fr.offset / int64(fr.chunkSize)
  stmt, err := fr.db.Prepare(`
      SELECT
        chunk
      FROM
        entries_data
      WHERE
        id=? AND
        chunk_index>=?
      ORDER BY
        chunk_index ASC
      `)
  if err != nil {
    log.Printf("reading chunk failed: %v", err)
    return err
  }
  defer stmt.Close()

  var chunk []byte
  err = stmt.QueryRow(fr.entryID, startChunk).Scan(&chunk)
  if err != nil {
    return err
  }

  // Move the start index to the position in the chunk we want to read.
  readStart := fr.offset % int64(fr.chunkSize)

  fr.buf = bytes.NewBuffer(chunk[readStart:])
  fr.offset += int64(len(chunk)) - readStart

  return nil
}
錯誤出在 SQL 查詢的 WHERE 子句:
WHERE
    id=? AND
    chunk_index>=?
這個查詢原本應該只取回單一區塊的檔案資料。結果卻是把目標區塊以及之後的所有區塊都讀出來了。
修正方法很簡單,只要把 >= 改成 =:
WHERE
    id=? AND
chunk_index=?附註:讀到這段程式碼時,我也發現自己在不需要使用 prepared statement 的地方卻用了,不過我不認為這會影響記憶體。
Dan 的修改是在下載端,所以我原本不期待它能修復我在上傳時看到的當機。而事實上也沒有,但它在提供下載的效能上帶來了顯著的改善。特別是在串流影音這類內容時,當我在檔案中跳到不同位置,PicoShare 的反應變得靈敏許多。
移除 SQLite 交易
在 Twitter 討論串中,有好幾個人建議 PicoShare 的 SQLite 交易很可能是導致記憶體膨脹的原因。
當 PicoShare 把檔案資料寫入 SQLite 時,我是在交易中進行的。目的是確保資料庫永遠處於一致的狀態。
透過使用交易,SQLite 保證如果部分寫入失敗,我永遠不會遇到只有部分檔案在資料庫中的狀態。它也確保我不會意外地只寫入檔案詮釋資料而沒寫入檔案內容,反之亦然。
Google 搜尋結果顯示大型的 SQLite 交易可能是記憶體膨脹的來源,所以我覺得值得一試。我嘗試改成立即提交變更到 SQLite,而不是使用交易,但記憶體還是膨脹。看起來交易並沒有造成差異。
記憶體膨脹沒關係,但當機不行
在這個階段,我從三個不同角度測量記憶體使用量,結果卻彼此不一致:
- Go 的除錯指標,顯示它已配置了多少記憶體
- VM 內的
htop - Fly 從 VM 主機端提供的記憶體指標


我用來測量記憶體使用量的不同工具,結果彼此不一致
特別是 Fly 的指標經常顯示記憶體已滿載,但 Go 和 htop 卻顯示幾乎沒什麼使用量。除錯過程令人沮喪,因為我越深入挖掘,記憶體測量結果就越偏離我實際觀察到的當機行為。
關鍵的轉折來自 Andrew Ayer,他指出記憶體膨脹很可能是個假議題:

Fly 的執行長 Kurt Mackey 也跳進討論串來證實 Andrew 的假設:

所以,Fly 的記憶體指標包含了 page cache,但 VM 在執行中的應用程式需要記憶體時,理應會回收那些記憶體。
這是個重大的發現。由於很難重現記憶體不足的當機,我一直把記憶體膨脹當成當機的近似指標。但只要 VM 還有足夠記憶體讓我的處理程序繼續跑,記憶體膨脹其實沒關係。
我現在必須重新評估一切。當我排除其他修正時,到底是因為它們造成了無害的記憶體膨脹?還是我真的觀察到當機了?
重新檢視 SQLite 交易
考慮到 Andrew Ayer 關於記憶體膨脹的說法,我重新檢視了 PicoShare 的 SQLite 交易。當我嘗試不用交易的實作時,我看到的是當機還是只是記憶體膨脹?我已經想不起來了。
我再次嘗試執行沒有交易的版本。果然,記憶體雖然膨脹,但 PicoShare 持續運作。我同時平行上傳了三個 618 MB 的檔案,每個上傳都成功了,PicoShare 也持續回應 HTTP 請求。

成功了!我終於找到效能問題的根源。
至少我當時是這麼想的……
我讓伺服器放著跑了一整晚,隔天早上查看時,它又以同樣的記憶體不足錯誤掛掉了。

取消 SQLite vacuuming
我馬上懷疑隔夜的當機與 SQLite VACUUM 指令有關,這個指令會壓縮資料庫檔案以回收未使用的磁碟空間。
當時沒有人在使用那台 PicoShare 伺服器,但當機時間點剛好與 PicoShare 排程的資料庫維護吻合。每隔七小時,PicoShare 就會從資料庫中移除過期的項目,並執行 VACUUM 來回收未使用的磁碟空間。
我在伺服器上測試執行 VACUUM 指令,發現它確實縮小了主 .db 檔案的大小,但卻讓 SQLite write-ahead log 的大小增加了。

這時,Ben 問我為什麼需要 VACUUM:
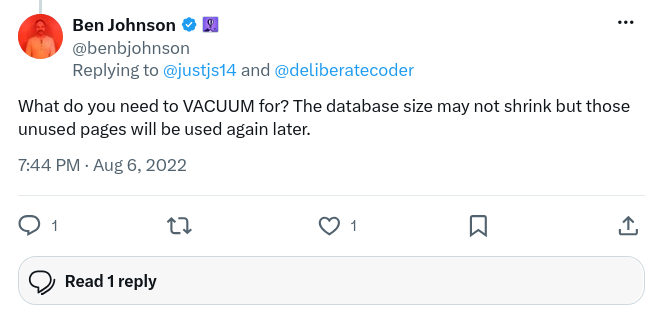
對啊,我為什麼要這麼做?
當我剛推出 PicoShare 時,使用者抱怨刪除檔案後沒有釋出磁碟空間。這對我沒什麼影響,因為我在 Fly VM 上用的是固定大小的磁碟區,所以用了多少磁碟空間都無所謂。但加上定期的 VACUUM 很簡單,所以我就加了。
仔細想過後,我決定改變 PicoShare 的行為,讓 VACUUM 預設關閉,但使用者可以透過命令列旗標啟用它。
dbPath := flag.String("db", "data/store.db", "path to database")
vacuumDb := flag.Bool("vacuum", false, "vacuum database periodically to reclaim disk space")
flag.Parse()
成功:PicoShare 在 256 MB 記憶體上穩定運行
在預設停用 VACUUM 並加上其他效能修正後,PicoShare 終於能在低記憶體下穩定運行了。
我在只有 256 MB 記憶體的 Fly VM 上連續執行 PicoShare 24 小時,都沒有發生任何當機。


過去 24 小時內 100% 正常運作
其他學到的經驗
除了上述的收穫,我在這次除錯過程中也學到了一些有用的額外經驗。
最佳化建置與測試的循環
有一件事我希望能更早做到,就是最佳化建置與測試的循環。為了測試任何一個假設,我的流程是:
- 將變更部署到 Fly(2-3 分鐘)
- 上傳一個大檔(1-2 分鐘)
- 等待 Fly 的記憶體指標更新(30-60 秒)
所以,光是測試一個變更就要花上六分鐘,而且每個步驟都需要手動操作。這還沒算上寫程式碼的時間。
我本來試過在限制記憶體的 Docker 容器中執行 PicoShare,但它從來沒有當掉過。
RAM_LIMIT="64m"
PORT=3001
PS_SHARED_SECRET="somesecretpass"

docker run \
  --memory "${RAM_LIMIT}" \
  --env "PORT=${PORT}" \
  --env "PS_SHARED_SECRET=${PS_SHARED_SECRET}" \
  --publish "${PORT}:${PORT}/tcp" \
  --name picoshare \
  mtlynch/picoshare:1.1.7
$ docker stats
CONTAINER ID NAME CPU % MEM USAGE / LIMIT MEM % NET I/O BLOCK I/O PIDS
1ababd398113 picoshare 3.82% 63.68MiB / 64MiB 99.50% 278MB / 208MB 6.09GB / 7.1MB 21我還是不明白為什麼 PicoShare 在 Docker 下的行為會和在真正的 VM 上不同,但我最好的猜測是 Docker 其實沒有像 VM 那樣嚴格地限制記憶體使用量。
當 Dan Wilhelm 回報他在本地執行 PicoShare 並觀察記憶體使用量所取得的進展時,我才意識到自己每次為了改動都部署到 Fly 浪費了多少時間。我試著在自家的 VM 伺服器上執行 PicoShare,但它從來沒有像在 Fly 上那樣當掉或膨脹記憶體。
最後奏效的方法是在 Fly 上建立自己的開發環境。我寫了一個Dockerfile,裡面包含了 PicoShare 的原始碼和一些開發工具,然後把它部署到 Fly。接著我就可以用 fly ssh console 在伺服器上開啟 shell,快速測試程式碼變更。
雖然還是不算非常快,因為 Fly 的記憶體指標更新大約有 30 秒的延遲,但比起每次都要從頭部署,已經是很大的進步了。
用清楚的 git 分支與提交訊息來記錄筆記
在這次調查中,我發現一個很有用的技巧:把每個假設都放在獨立的 git 分支中測試,然後用提交訊息記錄結果:

有這麼多不同的假設在流傳,很難記得測試每個想法時程式碼是處於什麼狀態。舉例來說,有一次我看到的當機其實是我在除錯時引入的新錯誤所導致的。
有了程式碼狀態以及測試方式的紀錄,幫我整理思緒,也避免重複白工。
Go 的測量工具看不到 cgo 中的記憶體配置
我最早的除錯步驟之一,是在 PicoShare 中新增一個頁面來顯示 runtime.ReadMemStats 的一些記憶體指標(我後來才發現 net/http/pprof 在這方面做得更好)。

James Tucker 指出,這個測量方式會排除任何透過 cgo 配置的資源:

我的確是透過 cgo 使用 SQLite。PicoShare 使用的是 mattn/go-sqlite3,這是 Go 最熱門的 SQLite 函式庫。
這也很合理,使用 cgo 會讓 Go 無法顯示準確的效能指標。如果你用 Go 去呼叫外部的 C 程式碼,Go 就無法追蹤外部程式碼中的資源。
為了解決這個問題,我嘗試使用 modernc.org/sqlite,這是一個純 Go 實作的 SQLite。但不知為何,我用純 Go 的程式碼也同樣看不到資源洩漏的情況。
Fly 的磁碟效能快得驚人
有一次,Twitter 上的留言者建議我可能是因為磁碟寫入而耗盡了記憶體。如果 PicoShare 寫入 Fly VM 磁碟的速度比磁碟實際寫入實體媒體的速度還快,資料就會在記憶體中排隊。
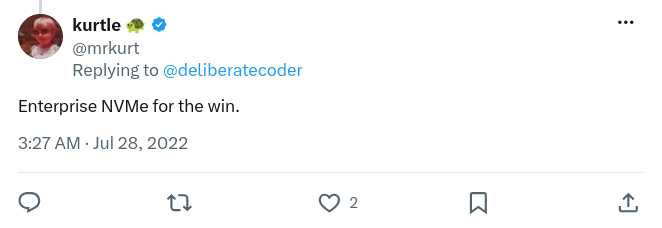
為了驗證這個理論,我使用了我從未用過的 fio 磁碟基準測試工具。我以為自己用錯了工具,因為它回報的寫入速度高達 3353 MB/s,這對雲端 VM 來說似乎快得不可思議。作為對照,這比我在自家 NAS 伺服器上做同樣測試時快了大約 30 倍。
Kurt Mackey 證實這些測量結果很可能是正確的,因為 Fly 的本地磁碟是企業級 NVMe 硬碟:
死胡同
雖然我很希望我的調查過程是一路穩定進展,但我也繞了不少遠路,追了很多最終毫無結果的假設。以下是其中一些死胡同。
怪罪 Litestream
除錯的第一條規則就是先假設問題出在自己的程式碼上。但我在這裡違反了這條規則,部分原因是因為我很怕得花多少工夫去追這些錯誤。
話說回來,懷疑 Litestream 也有其正當理由。雖然 PicoShare 以奇怪的方式使用 SQLite,但在 SQLite 中儲存 1 GB 的資料其實也沒那麼奇怪。Litestream 還很新,而且以新穎的方式使用 SQLite,所以會聯想到當機是 Litestream 造成的,也不算太牽強。
即使我懷疑 Litestream,我也不想給 Litestream 的維護者 Ben Johnson 增加額外工作。我知道 PicoShare 對 Litestream 來說是個不尋常的使用情境,而且我也沒有一個簡單的重現步驟來隔離問題。
但在五月,Fly 收購了 Litestream並聘請 Ben 來維護它。現在似乎正是拿這個問題去煩 Ben 的好時機,因為這同時牽涉到 Litestream 和 Fly!
我在 Litestream 上提交了一個錯誤回報,說明我嘗試過什麼以及為何認為問題與 Litestream 有關。結果 15 分鐘後,我就在停用 Litestream 的情況下讓 PicoShare 當掉了,所以我又把這個回報關掉了。
話雖如此,在 Litestream 上提交這個 issue 還是有用的,因為它迫使我必須夠嚴謹地處理問題,才能寫出一份詳細的錯誤回報。而且這也引起了 Ben 的好奇心,讓他在確認 Litestream 不是原因之後,仍提供了許多有用的建議。
怪罪 Fly
當我在本地的 VM 或 Docker 下無法重現當機時,我開始懷疑問題出在 Fly 身上。這看起來不太可能,因為我並沒有做什麼特別花俏的事,所以如果 Fly 的其他使用者都沒發現自己的部署會因記憶體不足而掛掉,那才奇怪。
但我還是想排除 Fly 的可能性。我把 PicoShare 部署到 Lightsail,這是 Amazon 的託管 Docker 容器服務。他們沒有 256 MB 記憶體的選項,所以我部署到 512 MB 的機器上。幾分鐘內,我就在那裡重現了當機,排除了 Fly 是兇手的可能。
/tmp 不是 RAM 磁碟
在 Twitter 討論串中,有幾位留言者建議 Fly 可能把暫存目錄掛載成 RAM 磁碟。Go 的 ParseMultipartForm 函式會把檔案上傳暫存在暫存目錄中,所以如果 Fly 把暫存目錄掛載成 RAM 磁碟,就能解釋為什麼一般的檔案上傳會耗盡記憶體。
但當我執行 lblk 時,並沒有看到任何跡象顯示 /tmp 或其他暫存目錄是 RAM 磁碟。系統看起來就只有一般的磁碟:
$ lsblk
NAME MAJ:MIN RM SIZE RO TYPE MOUNTPOINTS
vda  254:0    0  128M  0 disk
vdb  254:16   0    8G  0 disk /
$ du -h /tmp/*
149.3M /tmp/multipart-338465586
7.66 /tmp/test1
手寫一個 multipart 表單讀取器
Go 標準函式庫的 ParseMultipartForm 函式看起來消耗的記憶體比文件所述的上限還多,這是個警訊。我也注意到,如果我呼叫 ParseMultipartForm 然後丟棄那些位元組,同樣也會讓記憶體滿載。
為了看看能否繞過 ParseMultipartForm 的問題,我嘗試為我的特定情境手寫一個精雕細琢的 multipart 讀取器。
可惜,我的 multipart 讀取器表現並沒有比標準函式庫好,但能以更低階的方式玩玩 multipart 資料也算有趣。
限制上傳速度
我很好奇如果把資料上傳得慢一點,是否會對記憶體有任何影響。我嘗試從客戶端限制上傳速度,方法是把 Chrome 設定為模擬 3G 網速,但 PicoShare 的行為還是一樣。
我也嘗試在伺服器端限制寫入磁碟的速度,但同樣沒有任何作用。
不過我也因此學到在 Go 中限制 I/O 有多簡單。如果你正在處理 io.Reader 介面,只要用一個受限的 reader 包起來就行,像這樣:
import "github.com/juju/ratelimit"

...

throttleRate := 1 << 20 // 1 MB
bucket := ratelimit.NewBucketWithRate(float64(throttleRate), throttleRate)
throttledReader := ratelimit.Reader(reader, bucket)

w := file.NewWriter(tx, metadata.ID, d.chunkSize)
if _, err := io.Copy(w, throttledReader); err != nil {
  return err
}
PicoShare 1.2.0
上週末,我發布了 PicoShare 的 1.2.0 版本,其中包含了我在這次調查中發現的所有效能問題的修正。
致謝
非常感謝所有幫我調查這個問題的人,但要特別感謝以下幾位付出額外心力的朋友:
留言
登入後參與討論