用 Rust 與 WebAssembly 打造的微型靜態全文搜尋引擎
原文由 Matthias Endler 于 發布,訂閱此部落格
我寫了一個可以加到靜態網站上的基本搜尋模組。它非常輕量(gzip 壓縮後僅 50kB–100kB),支援 Hugo、Zola 和 Jekyll。目前只支援完整單字的搜尋。左側就有一個搜尋框可以試用。程式碼放在 GitHub 上。
靜態網站產生器很神奇。它們兼具兩者的優點:擁有動態內容,卻不犧牲效能。
這些年來,這個部落格先後跑在 Jekyll、Cobalt,最近則是 Zola 上。
不過,有一件事我一直不太喜歡:靜態網站居然沒有「靜態」的搜尋引擎。結果大家只能轉向自訂 Google 搜尋、像 Algolia 這類外部搜尋引擎,或是 lunr.js、elasticlunr 這種純 JavaScript 的解決方案。
這些方案對大多數網站來說都堪用,但總覺得不是最終的解答。
我不想再多一個對 Google 的依賴;也不想用像 Algolia 這樣獨立的網路後端,它會增加延遲,而且是專有軟體。
另一方面,我也不是很喜歡大量使用 JavaScript 的網站。舉例來說,單是 lunr 產生的搜尋索引就可能有好幾 MB 大小。就算以今天的頻寬標準來看,也覺得有點奢侈。更不用說,解析 JavaScript 至今仍然很耗時。
我想要的是簡單、精簡而且自給自足的搜尋功能,可以跟其他靜態內容一起部署。
因此,我乾脆完全沒在部落格上加搜尋功能。這其實有點可惜,因為文章越來越多,要找到相關內容也越來越難。
發想
很多年前的 2013 年,我讀到了 “Writing a full-text search engine using Bloom filters”——那真是一大啟發。
點子很簡單:把我所有的部落格文章丟進一個產生器,用這個神奇的資料結構——✨Bloom Filter ✨——來建立一個微小、自給自足的搜尋索引。
等等,什麼是 Bloom Filter?
Bloom filter 是一種節省空間、可用來檢查某個元素是否在集合中的方法。
訣竅在於,它並不是真的儲存元素本身;它只是能以某種程度的信心判斷某個元素曾經被存過。以我們的例子來說,它能以一定的錯誤率來判斷某個單字是否在一篇文章中。

以下是原文中為每篇文章產生 Bloom filter 的 Python 程式碼(感謝 Stavros Korokithakis 提供):
filters = {}
for name, words in split_posts.items():
  filters[name] = BloomFilter(capacity=len(words), error_rate=0.1)
  for word in words:
    filters[name].add(word)
記憶體佔用非常小,這要歸功於 error_rate,它允許極少量的偽陽性。
我立刻就知道,我的首頁也想要這樣的東西。我的想法是直接把 Bloom filter 和搜尋引擎一起送到瀏覽器端。這樣我終於可以擁有小巧、靜態又不需要後端的搜尋功能了!
卡關
但很快就幻滅了。
我完全不知道該如何打包、壓縮所產生的 Bloom filter,更別說要在客戶端上執行了。原文對此只有輕輕帶過:
你需要在客戶端實作 Bloom filter 演算法。這段程式碼大概不會比倒排索引的搜尋演算法長太多,但很可能還是稍微複雜一點。
我對自己的 JavaScript 能力沒什麼信心,覺得做不到。回想 2013 年,NPM 才剛滿三歲,WebPack 也才一歲,我甚至不知道該去哪裡找現成的解決方案。
不知道下一步該怎麼辦,這個點子就一直只是空想。
新的希望
五年後,到了 2018 年,網路世界已經截然不同。打包工具無所不在,Node 生態系也蓬勃發展。其中有一件事,特別讓我對這個微型靜態搜尋引擎的夢想重燃希望:WebAssembly。
WebAssembly(簡稱 Wasm)是一種針對堆疊式虛擬機器的二進位指令格式。Wasm 被設計為 C/C++/Rust 等高階語言的可攜編譯目標,讓應用程式得以在網頁的客戶端與伺服器上部署。[source]
這意味著我可以用自己熟悉的語言來寫客戶端程式碼——Rust!🎉
我的旅程從 2018 年 1 月的原型開始。那只是把上面 Python 版本直接移植過來:
let mut filters = HashMap::new();
for (name, words) in articles {
  let mut filter = BloomFilter::with_rate(0.1, words.len() as u32);
  for word in words {
    filter.insert(&word);
  }
  filters.insert(name, filter);
}
雖然我成功為每篇文章建立了 Bloom filter,但我還是完全不知道該怎麼把它打包到網頁上……直到 2018 年 2 月 wasm-pack 出現。
糟糕!我把 Rust 程式碼送進你的瀏覽器了。
現在我已經湊齊了拼圖的所有碎片:
- Rust —— 我用得順手的語言
- wasm-pack —— WebAssembly 模組的打包工具
- 一個可運作、作為概念驗證的原型
你在本頁左側看到的搜尋框就是成果。它完全是用 Rust 透過 WebAssembly 執行的(也就是所謂的 RAW stack)。喜歡的話,現在就可以試試看。
這一路上遇到了不少障礙。
Bloom Filter 相關的 Crate
我研究了幾個實作 Bloom filter 的 Rust 函式庫(crate)。
起初我試了 jedisct1 的 rust-bloom-filter,但它的型別沒有實作 Serialize/Deserialize。這代表我無法把產生的 Bloom filter 存進二進位檔中,再於客戶端載入。
嘗試了其他幾個之後,我找到了支援序列化的 cuckoofilter crate。它的行為和 Bloom filter 類似,如果你對兩者的差異有興趣,可以參考這篇整理。
使用方式如下:
let mut cf = cuckoofilter::new();

// Add data to the filter
let value: &str = "hello world";
let success = cf.add(value)?;

// Lookup if data was added before
let success = cf.contains(value);
// success ==> true
來看看用 cuckoo filter 為我部落格上的十篇文章打包後的輸出大小:
~/C/p/tinysearch ❯❯❯ l storage
Permissions Size User    Date Modified Name
.rw-r--r--   44k mendler 24 Mar 15:42  storage
44kB 聽起來還不差,但這僅僅是十篇文章的 cuckoo filter,以 Rust 二進位檔序列化後的結果。在此之上,我們還得加上搜尋功能和輔助程式碼。總計,使用原生的 wasm-pack 時,客戶端程式碼重達 216kB。太大了。
縮減二進位檔大小
在初版原型得到 216kB 這個令人清醒的結果後,我們有幾個方法可以把二進位檔縮小。
首先是遵循 johnthagen 關於縮減 Rust 二進位檔大小的建議。
只要在 Cargo.toml 中設定幾個選項,就能省下不少位元組:
"opt-level = 'z'" => 249665 bytes
"lto = true"      => 202516 bytes
"opt-level = 's'" => 195950 bytes
把 opt-level 設為 s 代表我們用速度換取體積,但我們目前本來就比較在意最小體積。畢竟,較小的下載大小本身也能提升效能。
接下來,我們可以試試 wee_alloc,這是一個能產生較小 .wasm 檔案的替代 Rust 分配器。
它專為那種一開始只做少數幾次動態大小配置,之後就不再配置、專心做重度運算的程式碼所設計。這種情境仍然需要有個分配器存在,但我們非常樂意用配置效能來換取更小的程式碼體積。
正是我們想要的。來試試看!
"wee_alloc and nightly" => 187560 bytes我們又從二進位檔中削掉了 4%。
出於好奇,我試著把 codegen-units 設為 1,也就是只用單一執行緒來產生程式碼。令人意外的是,這讓二進位檔又稍微變小了一點。
"codegen-units = 1" => 183294 bytes接著我聽說了一個叫 binaryen 的 Wasm 最佳化工具。在 macOS 上可以透過 Homebrew 安裝:
brew install binaryen它提供了一個叫 wasm-opt 的執行檔,又幫我們多砍了 15%:
"wasm-opt -Oz" => 154413 bytes接著我移除了 web-sys,因為我們不需要綁定到 DOM:152858 bytes。
有個叫 twiggy 的工具可以分析 Wasm 二進位檔的程式碼大小。它印出了以下結果:
twiggy top -n 20 pkg/tinysearch_bg.wasm
 Shallow Bytes │ Shallow % │ Item
─────────────┼───────────┼────────────────────────────────
         79256 ┊    44.37% ┊ data[0]
         13886 ┊     7.77% ┊ "function names" subsection
          7289 ┊     4.08% ┊ data[1]
          6888 ┊     3.86% ┊ core::fmt::float::float_to_decimal_common_shortest::hdd201d50dffd0509
          6080 ┊     3.40% ┊ core::fmt::float::float_to_decimal_common_exact::hcb5f56a54ebe7361
          5972 ┊     3.34% ┊ std::sync::once::Once::call_once::{{closure}}::ha520deb2caa7e231
          5869 ┊     3.29% ┊ search
就我所見,二進位檔中最大的一塊是文章的原始資料區段。再來是函式標頭,以及一些浮點數轉十進位的輔助函式,那些很可能是來自反序列化。
最後,我試了 wasm-snip,它會把 WebAssembly 函式的本體替換成 unreachable,像這樣,但並沒有減少程式碼大小:
wasm-snip --snip-rust-fmt-code --snip-rust-panicking-code -o pkg/tinysearch_bg_snip.wasm pkg/tinysearch_bg_opt.wasm在稍微調整了 cuckoo filter 的參數並從文章中移除停用詞後,我把大小降到了 121kB(gzip 後 51kB)——考慮到網路上圖片的平均大小約為 900kB,這已經算不錯了。更棒的是,搜尋功能只有在使用者點進搜尋框時才會載入。
更新
最近我把專案從 cuckoofilter 遷移到了 XOR filter。我用了很棒的 xorf 專案,它內建了 serde 序列化,讓我得以移除大量自訂程式碼。
透過這個改動,我又把 payload 大小再減少了 20–25%。現在我的部落格已經降到 99kB(49kB gzipped)了。🎉
新版本已經在 crates.io 上發布,有興趣的話可以試試看。
前端與膠合程式碼
wasm-pack 會自動產生用來與 Wasm 溝通的 JavaScript 程式碼。
至於搜尋介面,我是從 w3schools 拿來一些 JavaScript 和 CSS 片段再加以客製化。它甚至支援鍵盤操作!現在當使用者輸入搜尋查詢時,我們會逐一檢查每篇文章的 cuckoo filter 來嘗試比對單字,並以命中次數來計分。感謝我的好同事 Jorge Luis Betancourt 幫忙加入這部分。
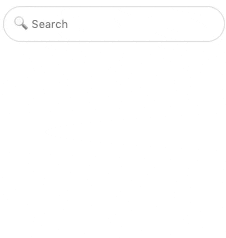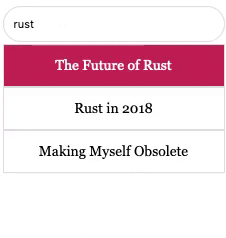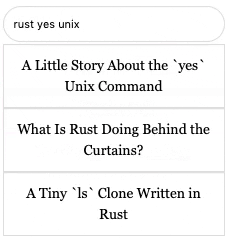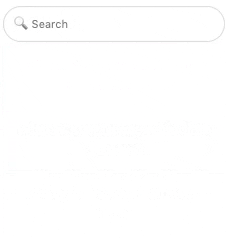
(有趣的是,這段動畫的大小跟未壓縮的 Wasm 搜尋本身差不多。)
限制
只會比對完整單字。我很想加入前綴搜尋,但嘗試後發現二進位檔會變得太大。
使用方式
用來產生 Wasm 檔案的獨立執行檔叫做 tinysearch。它只需要一個指向 JSON 檔案的路徑作為輸入:
tinysearch path/to/corpus.json這個 corpus.json 包含了你想建立索引的文字。格式相當直觀:
[
  {
    "title": "Article 1",
    "url": "https://example.com/article1",
    "body": "This is the body of article 1."
  },
  {
    "title": "Article 2",
    "url": "https://example.com/article2",
    "body": "This is the body of article 2."
  }
]
你可以用任何靜態網站產生器來產生這個 JSON 檔。這是我為 Zola 寫的版本:
{% set section = get_section(path="_index.md") %}

[
  {%- for post in section.pages -%}
    {% if not post.draft %}
      {
        "title": {{ post.title | striptags | json_encode | safe }},
        "url": {{ post.permalink | json_encode | safe }},
        "body": {{ post.content | striptags | json_encode | safe }}
      }
      {% if not loop.last %},{% endif %}
    {% endif %}
  {%- endfor -%}
]
我很確定 Jekyll 的版本看起來也會很類似。這裡有個起點可以參考。如果你為自己的靜態網站產生器弄出了可用的版本,請告訴我。
心得
- 這仍然是蠻荒西部:功能不穩定、要用 nightly 版 Rust、文件幾乎每天都在過時。
戴好你的思考帽! - 把一個好點子做成產品需要下很多功夫。你得兼顧很多面向:易用性、通用性、可維護性、文件等等。
- Rust 很擅長移除無用程式碼,所以通常你不會為沒用到的東西付出代價。不過我還是會建議你對加到 Wasm 二進位檔中的依賴保持非常保守,因為很容易為了加入其實不需要的功能而讓二進位檔變大。舉例來說,我在測試期間用了 StructOpt,還寫了一個會解析這些命令列參數的
main()函式。這對 Wasm 來說根本不需要,所以我後來就移除了。 - 我能理解不是每個人都想寫 Rust 程式。入門有點複雜,但酷的是你幾乎可以用任何其他語言。舉例來說,你可以寫 Go 再轉譯成 Wasm,或如果你偏好 PHP 或 Haskell 也行。現在已經有許多語言支援了。
- 很多人把 WebAssembly 當成玩具技術嗤之以鼻。他們大錯特錯。在我看來,WebAssembly 將會徹底改變我們為網路及更廣泛領域打造產品的方式。兩年前還很困難的事,現在已經變得簡單:把任何語言寫的程式碼送到各個瀏覽器上。我對它的未來感到無比期待。
- 如果你在為公司網站尋找可自行託管的獨立搜尋索引,可以看看 sonic。也可以參考 stork 這個替代方案。
試試看!
請留意以下限制:
- 只會搜尋完整單字。沒有搜尋建議。原因是前綴搜尋會讓二進位檔大小像薄荷糖加可樂一樣爆開。
- 由於我們把所有文章的搜尋索引都打包進同一個靜態二進位檔中,我只建議在中小型網站上使用。預期每篇文章大約會增加 4kB(未壓縮)。
編譯時間慘不忍睹(在我的機器上全新安裝後重新建置索引大約要 1.5 分鐘),主要是因為每次重建索引時都要從頭編譯 Rust crate。
更新:這點在 CephalonRho 於 PR #13 的出色貢獻後已大致解決。再次感謝!
最終的 Wasm 程式碼快如閃電,因為我們省去了對搜尋伺服器的來回請求。即時的回饋感更像是篩選清單,而不是在文章中搜尋。它甚至可以完全離線運作,如果你想把它跟應用程式一起打包,這點也許很不錯。
留言
登入後參與討論