微前端的快取與 CDN
原文由 Alex O'Callaghan 于 發布,訂閱此部落格
在微前端架構中處理快取,遠比單體式前端來得細緻。你會同時面對 shell、多個遠端清單,以及它們所參照的 chunk,每一種資源的部署節奏不同,對內容過時的容忍度也不一樣。本文將分享我們在 Mintel 的做法、過去曾出過什麼問題,以及至今仍未完全解決的部分。
更新 — 2026 年 6 月:我後續又寫了一篇優化微前端快取策略的後續文章,說明我們為了提升效能、降低頻寬成本所做的調整。
我們的技術堆疊
我們使用 Webpack Module Federation 運行約 30 個微前端。shell 是一個純靜態的 Jamstack 應用程式,部署至 S3,透過 CloudFront 提供服務,最外層則由 Akamai 統一擋在最前方。所有遠端都位於固定且眾所皆知的 URL 上。
部署只需要一道 rclone 指令,就會把建置好的 dist 目錄複製到 S3 上各個微前端專屬的子目錄中。shell 與每一個遠端都是獨立部署、由不同團隊各自維護。
我們如何針對不同類型的資源設定快取
不同類型的資源有不同的快取需求。以下是我們目前的設定方式與背後的原因。
index.html - no-cache
shell 的 index.html 負責啟動整個應用。如果它是舊的,下游的一切都可能出錯。我們透過 S3 物件的中繼資料為它設定 Cache-Control: no-cache 標頭,並在部署流程中自動完成。
no-cache 並不代表檔案不會被快取。它的意思是,CDN 或瀏覽器在提供快取內容前,必須先向來源重新驗證。如果來源回傳 304,就會沿用快取的版本;若內容已有更新,則會回傳最新的檔案。
remoteEntry.js - 永不快取
remoteEntry.js 是 Module Federation 的清單檔。它告訴 shell 要去哪裡找到某個遠端的 chunk。當你部署遠端時,這個檔案的內容會變動,但檔名不變。
過時的 remoteEntry.js 會導致兩種失敗情境。比較明顯的是直接報錯:如果它指向已被替換掉的舊版 chunk,就會在執行時出錯。另一種則較為隱晦:使用者在拿到最新的清單檔之前,都不會看到新版的應用程式。這會導致遠端團隊明明已經發布了修正或新功能,使用者卻因為清單檔過時而持續執行舊版程式碼。
在 Akamai 這一層,我們對 remoteEntry.js 設定了 Cache-Control: no-store, max-age=0,避免它被瀏覽器快取。我們也透過 動態遠端載入,使用 module-federation-import-remote 套件,該套件預設會在 remoteEntry.js 的 URL 後面加上用於破壞快取的查詢參數。由於我們的 CloudFront 分發會將查詢字串納入快取鍵,即使檔案在 CloudFront 上有快取,每次請求也會因為 URL 不同而繞過快取,直接從 S3 取得最新版本。
Chunk - 未設定明確的標頭
remoteEntry.js 所參照的 JS chunk,是透過 Webpack 的 contenthash 替換機制來做內容定址。當檔案內容改變時,雜湊值會跟著改變,檔名也就不同。這代表你可以放心地對這些 chunk 做積極的快取——新部署會產生新的檔名,CDN 自然會將它們視為全新的資源。
在你的 output.filename 中這樣設定即可:
output: {
  filename: '[name].[contenthash].js',
}
我們曾遇過團隊忘記為遠端的資源檔名設定 contenthash 的情況。chunk 以可預期的檔名部署後被快取,後續的部署直到快取的 TTL 自然到期前,都不會反映給使用者。
我們目前並未對 chunk 設定明確的 Cache-Control 標頭。CloudFront 會根據來自 S3 的 Last-Modified 或 ETag 標頭,推算出一個啟發式的 TTL 來快取這些檔案。在 Akamai 這一層,我們對來源回應設定了 no-store 行為,因此所有快取只會發生在瀏覽器或 CloudFront。
404 處理
我們的 shell 是單頁應用程式,路由在前端處理。如果使用者直接前往某個路徑或重新整理頁面,CDN 會嘗試在 S3 上尋找該路徑對應的檔案,找不到時預設就會回傳 404。
解法是在 CloudFront 設定當來源回傳 4xx 錯誤時,一律回傳 index.html。AWS 在 CloudFront 分發設定中將此稱為自訂錯誤回應。
Akamai 會將所有不符合已知 API 或 MPA 路由的請求,代理轉發給 CloudFront,因此這種 fallback 行為是在 CloudFront 層處理,並套用至所有微前端路由。
使用者請求流程
遠端採用延遲載入,以 React.lazy 與動態 import 包裝。只有當使用者導向需要該遠端的頁面時,shell 才會去抓取對應的 remoteEntry.js。
CloudFront / S3 故障事件
上述架構是隨著時間逐步演變而來,部分原因正是為了回應過去的事故。2025 年 1 月,AWS 發生問題,導致我們的 CloudFront 來源無法從 S3 取得內容,進而產生 404 NoSuchBucket 錯誤。由於 CloudFront 已設定在收到來自 S3 的 4xx 回應時回傳 index.html——這是單頁應用程式常見的萬用設定——這些錯誤在抵達 Akamai 之前就被轉成了 200 回應。Akamai 無從得知發生異常,便照常將其快取起來。當 AWS 恢復正常後,使用者仍持續從 Akamai 邊緣節點以及自身的瀏覽器快取中,拿到這些錯誤的快取回應。
在 Akamai 上清除快取既慢又痛苦。你無法用萬用字元一次清除符合某個模式的所有路徑,必須提供明確的 URL。在擁有數十個微前端、數百個 JS chunk 檔案的情況下,這在緊急時刻根本不可行。我們最後只能聚在戰情室,手忙腳亂地送出一筆筆卡在載入中的清除請求,眼看著快取在幾個小時內隨著 TTL 陸續到期才慢慢失效。而且這也救不了那些已在瀏覽器中快取了錯誤回應的使用者。
我們最後找到的逃生門,是在幾個關鍵微前端的 Webpack 設定中修改 contenthash 的長度,然後重新部署。改變 contenthash 長度會讓所有產生的檔名都跟著改變,迫使 CDN 將它們視為全新資源,而非繼續提供快取的錯誤回應。這個方法奏效了,但它是在壓力下臨時想出來的,並非既有的標準作業流程。
自那之後,我們停用了 Akamai 對微前端資源的快取,並為 S3 儲存貯體加入了多區域容錯移轉,以降低再次陷入相同困境的風險。我們也開始對 index.html 明確設定 no-cache,確保變更能被快速套用,任何錯誤的 fallback 回應也不會被快取太久。
老實說,對於「如果又快取到錯誤回應該怎麼辦」的答案,至今仍然是:我們沒有一個乾淨俐落的解法。修改 contenthash 長度這招,仍是我們在需要緊急讓所有快取失效時,迫使所有檔名更新的核選項。
改善我們的快取策略
撰寫這篇文章的過程,讓我們有機會好好檢視目前的快取策略是如何運作的。快取設定並不是系統正常運作時會經常回頭檢視的東西,而現行的架構在實務上也還算撐得住。
然而,我們的快取設定分散在兩處:index.html 靠 S3 物件的中繼資料,remoteEntry.js 則靠 Akamai 規則,其他資源甚至完全沒有明確的快取標頭。沒有任何一個地方能一窺完整的快取策略全貌。我們也因為前次事故的慘痛經驗,完全停用了最外層 Akamai 的快取,但這正拖累效能並推升頻寬成本。
更乾淨的做法,是透過 S3 物件中繼資料,在來源端就為每種資源明確設定 Cache-Control 標頭,並將各層 CDN 視為遵循來源標頭的快取,而非定義快取策略的地方。這也意味著,即使未來更換或重新設定 Akamai,快取行為仍會跟著來源走,而不會無聲無息地消失。
我們目前完全沒有為 chunk 設定快取標頭,只能仰賴 CDN 與瀏覽器的啟發式邏輯來決定快取時間。若能為帶有內容雜湊的 chunk 明確設定 Cache-Control: max-age=31536000, immutable 標頭,並重新啟用 Akamai 遵循來源快取設定的行為,將會是很好的改進,能確保這些不可變資源被積極且正確地快取——但以現行架構,無法保證每個團隊都已正確地在建置輸出檔名中使用 contenthash。不過,確實有另一種能同時解決這兩個問題的做法,只是需要更大幅度的架構調整。
另一種選擇:版本化 URL 與探索服務
以上所有做法都假設遠端位於固定且眾所皆知的 URL。這是最簡單的部署模式,但也是導致 remoteEntry.js 快取難以處理的根本原因——因為當你在原地覆寫同一個檔案時,就永遠無法安心地長時間快取它。
更穩健的做法,是直接在 URL 中加入版本資訊:
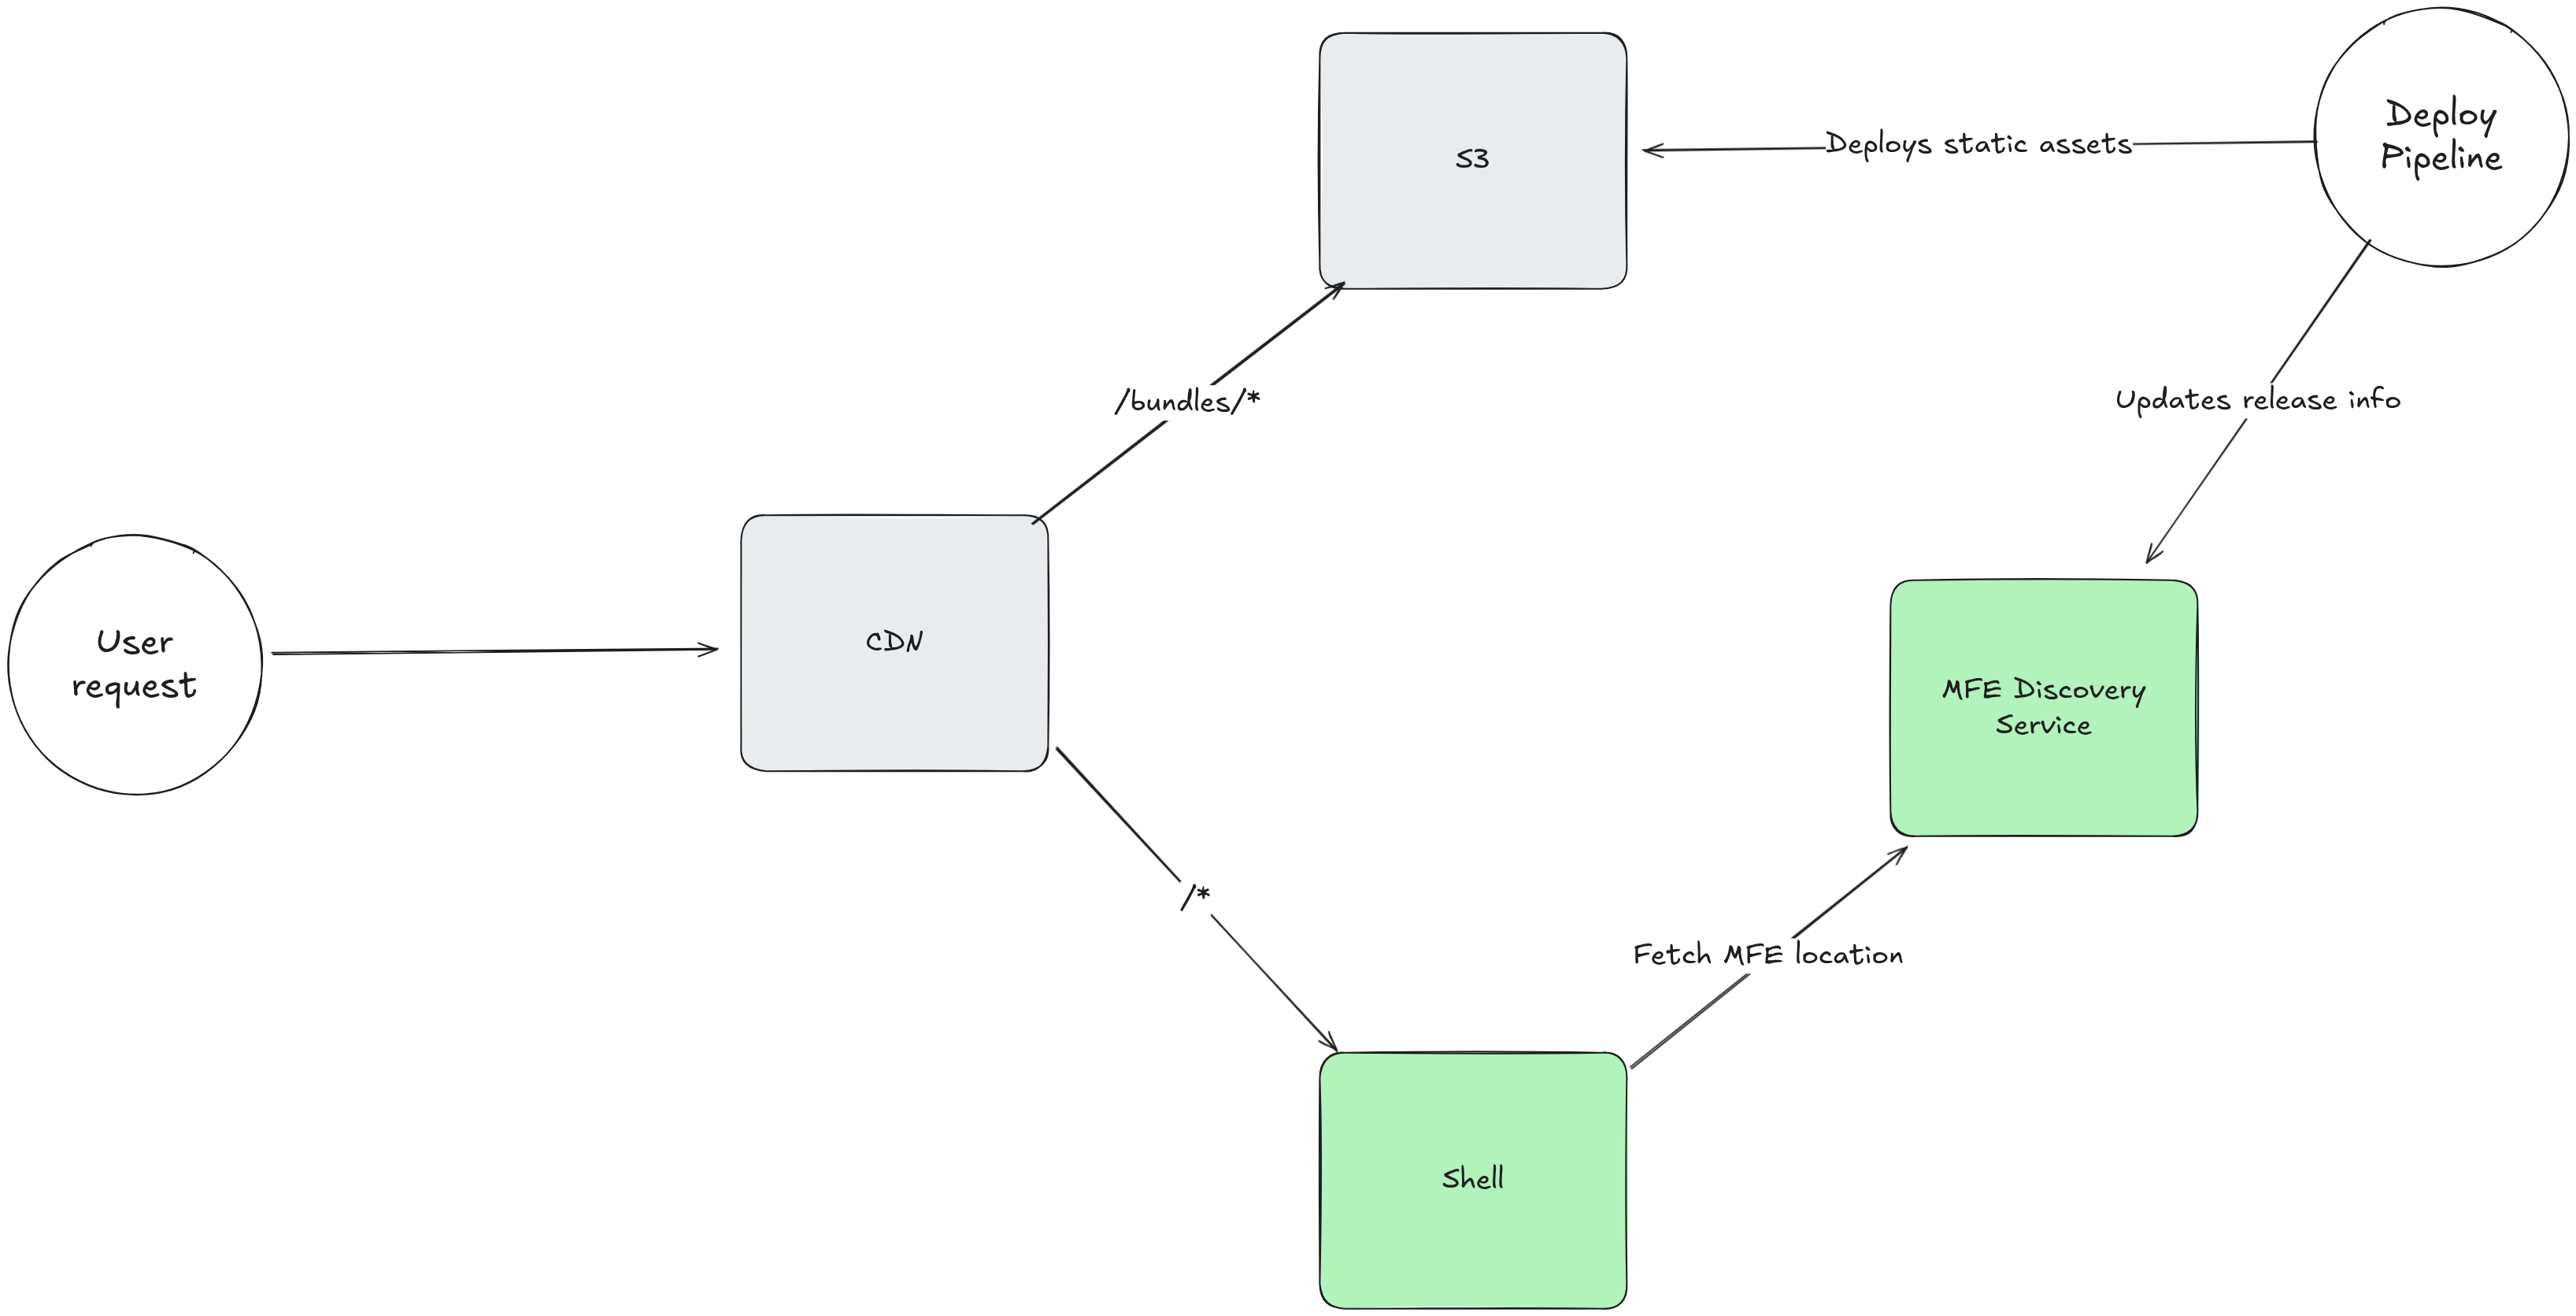
https://cdn.example.com/remote-a/v1.4.2/remoteEntry.js採用版本化路徑後,remoteEntry.js 就會像其他 chunk 一樣,成為一個內容定址的檔案。你可以用 max-age=31536000, immutable 來快取它。舊版本會一直保留在 S3 上,因此正在使用中的使用者不會因為一次部署而中斷。 rollback 也只需要將清單指向舊版本,而不需重新部署。
要讓這個機制運作,shell 就不能寫死遠端的 URL。你需要一個探索服務——讓 shell 在啟動時呼叫,以取得每個遠端當前的 URL:
{
  "remote-a": "https://cdn.example.com/remote-a/v1.4.2/remoteEntry.js",
  "remote-b": "https://cdn.example.com/remote-b/v2.1.0/remoteEntry.js"
}
然而我們並沒有採用這種做法,儘管一年多前我們就已識別出這個模式,並將其納入架構藍圖作為未來可能的選項之一。它確實能避免團隊漏設 contenthash 的問題,但那終究是紀律問題,不足以成為遷移 30 個微前端的理由。在每一層 CDN 上做更積極的快取,固然有助於效能並降低頻寬成本,但若沒有針對快取命中率與頻寬成本進行詳細分析,很難量化其實際效益;而且透過現行做法為 chunk 設定 immutable 標頭,也能達到類似效果。
擁有探索服務也能實現更複雜的部署模式,例如金絲雀發布或在部署層級做功能旗標,但這些都會增加複雜度與維運負擔。多數情況下,我們已能在應用程式邏輯內直接做功能旗標,更容易掌握使用者實際執行的程式碼。要讓金絲雀發布真正發揮作用,也需要在自動化監控與告警策略上投入相當的時間。
雖然探索服務仍是未來可能的選項,但我們目前更優先的行動,是在現有較簡單的部署模式下,持續改善當前的快取策略。
留言
登入後參與討論