Hacker News 문체 지문 재현하기
원문은 Salvatore Sanfilippo님이 에 게재했습니다. 이 블로그 구독하기
3년쯤 전, Hacker News에서 꽤 호기심 가는 흥미로운 글을 본 적이 있다. 크리스토퍼 태리(Christopher Tarry)라는 학생이 댓글에 등장하는 상위 단어들의 빈도 벡터에 대해 코사인 유사도를 적용해 비슷한 HN 계정을 찾아내는 방법을 선보였는데, 때로는 실제로 같은 사람이 운영하는 계정, 즉 글쓴이의 정체를 숨기기 위해 쓰는 부계정까지 잡아내기도 했다.
원본 글은 여기에서 볼 수 있다: https://news.ycombinator.com/item?id=33755016
당시 나는 문체 탐지에 쓰이는 Burrows-Delta 방법에 대해 전혀 몰랐다. 상위 단어들의 빈도 벡터를 정규화하기만 하면 그렇게 놀라운 결과가 나온다는 게 마치 마법처럼 느껴졌다. 위키피디아 페이지 몇 개를 읽고 머릿속에 메모해 두었다. 그러다 Redis용 Vectors를 작업하던 중 이 글이 떠올라 웹에서 검색해 보니 원본 페이지가 사라져 있었고, 저자가 원본 글이나 웹사이트에서 데이터가 어떻게 처리되고 상위 단어가 어떻게 추출되는지(특히 몇 개를 썼는지 등)를 제대로 설명하지 않았다는 걸 알게 됐다. 주요 작업이 끝나면 Vector Set으로 이 작업을 재현해 봐야겠다고 생각했다. 이제 새로운 데이터 타입이 릴리즈 후보에 올랐고, 마침 이 문제에 매달릴 시간을 찾았다. 아래는 내가 한 작업에 대한 보고서인데, 본격적으로 들어가기 전에 먼저 필수 데모 사이트부터 소개한다. 다음 링크에서 직접 시험해 볼 수 있다:
https://antirez.com/hnstyle?username=pg&threshold=20&action=search
참고: 데이터셋이 700MB의 RAM을 차지하기 때문에, 작은 서버를 쓰는 내 환경에서는 앞으로 몇 달 안에 이 사이트를 내릴 수도 있다. 다만 이 글 뒤쪽에서 모든 과정을 처음부터 재현할 수 있는 링크와 GitHub 저장소 코드를 찾을 수 있다.
참고 2: 웹사이트가 무사히 버텼으면 좋겠다. 아주 조악한 Python 스크립트로 만들었다. 이런 작은 서버에서도 VSIM 명령을 벤치마크해 보니 초당 8만 건의 VSIM을 처리하더라! int8 양자화와 몇 가지 추가 최적화 덕분이다. 하지만 Python 스크립트는 엉망이라 매번 새로운 Redis 연결을 만드는 식이다. 무사히 버티길 바랄 뿐이다.
원시 데이터 다운로드와 처리
자, 이런 걸 해보려면 가장 먼저 Hacker News 댓글 아카이브를 찾아야 했다. 다행히 HN 시작부터 2023년까지의 모든 게시물을 담은 것으로 보이는 아카이브가 있었고, 전체 용량이 10GB에 달했다. 여기에서 찾을 수 있다: https://huggingface.co/datasets/OpenPipe/hacker-news 솔직히 이 데이터가 스크래핑으로 얻어진 건지, 아니면 HN이 어떤 형태로든 공개하는 데이터인지는 잘 모르겠다.
나는 적어도 공개 데이터셋의 경우에는 바이너리 파일을 그다지 좋아하지 않아서, Parquet 파일을 더 작고 다루기 쉬운 형태로 변환하기 위해 두 개의 Python 스크립트를 사용했다. 첫 번째 스크립트인 gen-top-words.py는 바이너리 파일을 읽어 데이터셋에서 가장 많이 쓰인 상위 N개 단어 목록을 담은 txt 파일을 생성한다. 기본값은 1만 개 단어지만 통계 분석에는 훨씬 적은 수가 필요하다(사실 단어를 너무 많이 사용하면 문체가 아니라 사용자가 어떤 주제에 대해 이야기하는지가 잡히게 된다!). 이어서 다른 Python 스크립트가 각 사용자별로 모든 댓글을 모은 뒤, 사용자 이름과 해당 사용자가 HN 시작부터 2023년까지의 전체 기록에서 사용한 모든 단어의 빈도 테이블이라는 두 가지 키만 담은 아주 큰 JSONL 파일을 생성한다. 각 항목은 이런 식으로 생겼다:
{"by": "rtghrhtr", "freqtab": {"everyone": 1, "hates": 1, "nvidia": 1, "but": 1, "treats": 1, "ati": 1, "as": 1, "an": 1, "afterthought": 1, "another": 1, "completely": 1, "useless": 1, "tool": 1, "to": 1, "throw": 1, "on": 1, "the": 1, "pile": 1}}이 단계가 끝나면 마지막 스크립트인 insert.py가 진짜 작업을 수행할 수 있다. 각 사용자에 대해 Burrows 방법을 적용해 사용자 문체 벡터를 만들고 Redis에 넣는 것이다. 파일을 미리 처리해 두면(느린 작업이다) 삽입 스크립트를 다른 파라미터(특히 사용할 상위 단어 수)로 더 쉽게 호출해 Parquet 파일을 매번 다시 처리할 필요 없이 다양한 결과를 더 빠르게 확인할 수 있다는 장점이 있다.
Burrows 방법은 어떻게 동작할까?
원본 글에서 Christopher는 단어 사용 빈도를 정규화한 뒤 코사인 유사도를 적용하기만 하면 된다고 썼다. 사실 과정은 조금 더 복잡하다. 먼저, 이 방법이 본질적으로 어떻게 동작하는지 스스로에게 물어보자. 핵심은 각 사용자가 기대되는 ‘평균’ 언어에 비해 특정 단어를 과도하게 많이 쓰는지 혹은 적게 쓰는지를 포착하려는 데 있다. 이를 위해 실제로는 다음 단계들을 거친다(Python 코드에서 발췌).
상위 단어 각각에 대해 수행하는 작업은 다음과 같다:
# Convert to relative frequency
rel_freq = frequency / total_words

# Standardize using z-score: z = (freq - mean) / stddev
mean = word_means.get(word, 0.0)
stddev = word_stddevs.get(word, 1.0)  # Default to 1.0 to avoid division by zero

z_score = (rel_freq - mean) / stddev

# Set the z-score directly in the vector at the word's index
vector[word_to_index[word]] = z_score
먼저 사용자가 특정 단어를 사용한 빈도를 해당 단어의 *전체* 사용 빈도를 빼서 ‘중심화(centering)’한다. 이렇게 하면 사용자가 그 단어를 얼마나 적게(음수) 혹은 많이(양수) 썼는지를 나타내는 숫자가 된다. 하지만 생각해 보면, 서로 다른 필자 사이에서 사용 편차가 훨씬 큰 단어들은 그 변화가 덜 중요하다. 우리는 해당 단어의 일반적인 편차에 비해 이 사용자가 단어를 훨씬 더 과하게 혹은 과소하게 사용한 경우에 신호를 증폭시키고 싶다. 그래서 중심화된 빈도를 그 단어의 전체 표준편차로 나눈다. 이렇게 얻은 것이 바로 ‘z-score’로, 특정 단어가 한쪽 혹은 다른 쪽으로 얼마나 이상치인지를 보정한 지표다.
이제 Redis 벡터 셋에 벡터를 다음 명령 하나로 넣을 준비가 됐다:
VADD key FP32 [blob with 350 floats] username(여기서는 벡터 셋의 세부 사항은 다루지 않겠다. 문서는 여기에서 볼 수 있다 -> https://github.com/redis/redis/blob/unstable/modules/vector-sets/README.md)
Redis는 삽입된 벡터를 L2 정규화하지만, VEMB로 연관된 벡터를 조회할 때 값을 되돌려주기 위해 L2 값을 기억해 둔다. 따라서 z_score는 그대로 설정되었다.
마지막으로 VSIM으로 유사한 사용자를 찾을 수 있다:
127.0.0.1:6379> vsim hn_fingerprint ele pg
 1) "pg"
 2) "karaterobot"
 3) "Natsu"
 4) "mattmaroon"
 5) "chc"
 6) "montrose"
 7) "jfengel"
 8) "emodendroket"
 9) "vintermann"
10) "c3534l"
모든 코드(웹앱 자체 제외)는 여기에서 찾을 수 있다: https://github.com/antirez/hnstyle
README 파일에는 모든 과정을 재현하는 방법이 설명되어 있다.
왜 350개 단어인가?
이 블로그 글을 쓰게 만든 원본 글에서 빠져 있던 것 중 하나는 상위 단어를 몇 개 사용해야 하는가 하는 점이다. 단어를 너무 많이 사용하면 내 댓글 중 Redis에 대한 것들이 많이 잡히는데, Redis가 가장 많이 쓰인 1만 개 단어 중 하나이기 때문이다. 짐작했겠지만 나는 처음에 정확히 이 실수를 저질렀고, VSIM은 나와 *문체*가 비슷한 사용자가 아니라 나와 비슷한 주제에 대해 이야기하는 사용자들을 계속 반환했다. 다행히 인터넷 아카이브에 Christopher가 ‘pg’ 계정에 대해 낸 결과가 캐시되어 있었다:
https://web.archive.org/web/20221126235433/https://stylometry.net/user?username=pg
그래서 이제 상위 k개 단어를 조정해 비슷한 결과를 얻을 수 있었다. 또 원 논문들을 읽어 보니 놀랍게도 분석이 잘 동작하려면 150개 단어만으로도 충분하다는 걸 알게 됐다. 일반적으로 150~500개 범위가 최적이라고 여겨진다.
경고: 사용자를 검색했을 때 대부분 가짜 계정이 나올 거라고 생각하지 마라. 많은 가짜 계정은 데이터가 너무 적다. 사람들은 종종 일회용 계정을 만들어 댓글 몇 개만 달고 끝내기 때문이다. 그래서 특정 사용자 문체와 연결된 계정 대부분은 그냥 글쓰기 스타일이 비슷한 다른 사람들일 뿐이다. 이 방법은 누가 원어민이고 누가 아닌지를 구분하는 데 꽤 강력하다고 생각한다. 이는 아래 벡터 시각화에서 특히 잘 드러난다.
검증과 시각화…
내가 재현한 또 다른 것(역시 원 글 작성자의 아이디어다)은 같은 사용자를 antirez_A와 antirez_B처럼 두 가지 변형으로 나누어 서로 다른 댓글 집합으로 넣은 뒤, antirez_A와 유사한 사용자를 조회했을 때 B가 나오는지 확인하는 실험이었다. 실제로 내가 테스트한 *대부분*의 사용자에 대해 아주 잘 동작했고, 종종 가장 상위에 결과가 나왔다. 그래서 우리 방법이 실제로 동작한다는 걸 알 수 있다.
그런데 벡터만으로 문체를 그렇게 쉽게 ‘볼’ 수 있다면, 우리 맨눈으로는 어떨까? 최근 나는 터미널을 Ghostty로 바꿨는데, Kitty 그래픽 프로토콜을 지원해서 터미널 창 안에 비트맵을 바로 표시할 수 있다. 꽤 오래전부터 이 기능을 한번 써보고 싶었는데, 마침 시험해 볼 좋은 이유가 생긴 셈이다.
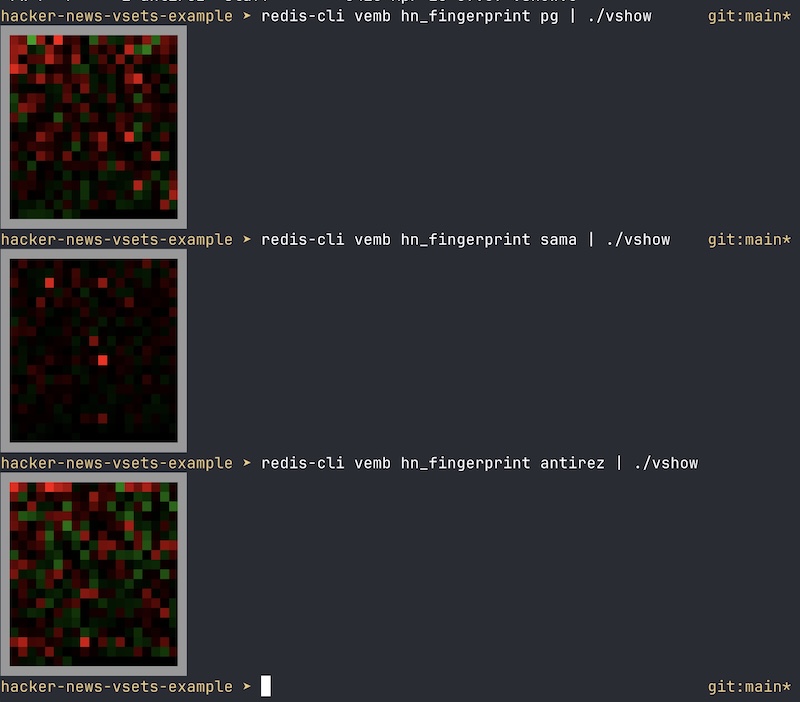
위에서 일어나고 있는 일은 VEMB 명령을 호출해 단순히 float 목록(벡터)을 반환받고, 저장소의 일부이기도 한 vshow 유틸리티가 벡터를 담을 수 있는 가장 작은 정사각형을 찾아 양수 값은 빨간색, 음수 값은 녹색으로 표시하도록 하는 것이다.
보다시피 원어민이 아닌 나는 아주 단순한 단어들을 과도하게 많이 쓰고 더 정교한 단어들은 적게 쓴다. 다른 저자들은 특정 단어를 강조하고, 또 어떤 이들은 훨씬 더 ‘담백’해서 인공적인 흔적이 적게 나타난다. 어느 순간 거기서 실제로 무슨 일이 일어나는지 궁금해졌다. 내가 어떤 단어를 너무 많이 쓰고 너무 적게 쓰는지 말이다. 그래서 데모 웹사이트에서는 버튼을 눌러 특정 사용자를 분석하고, 과도하게 많이 쓴 상위 10개 단어와 적게 쓴 상위 10개 단어를 볼 수도 있다. 내 경우 몇 개는 확실히 영어 문법에 대한 내 문제 때문인 것 같다 :D
자, 이 탐구는 여기까지! Vector Set은 이제 Redis 8 RC1에 들어갔고 나는 할 일이 더 남았지만, 이번 작업은 재미있었고 벡터가 AI 이전에도 확실히 멋졌다는 걸 보여준다고 생각한다. 이렇게 긴 글을 읽어줘서 고맙다.
수정: insert.py 스크립트가 사용자가 작성한 총 단어 수에 대한 JSON 메타데이터도 함께 넣는다는 걸 깜빡했다. 그래서 FILTER를 사용해 특정 단어 수 조건에 맞는 결과만 표시할 수 있다. 이는 부계정을 탐지하는 데 유용할 수 있는데, 부계정은 정체를 숨겨야 할 때만 드물게 사용되는 경우가 많기 때문이다:
127.0.0.1:6379> vsim hn_fingerprint ele pg FILTER ".wordcount < 10000"
 1) "montrose"
 2) "kar5pt"
 3) "ryusage"
 4) "corwinstephen"
 5) "ElfinTrousers"
 6) "beaned"
 7) "MichaelDickens"
 8) "bananaface"
 9) "area51org"
10) "william42"
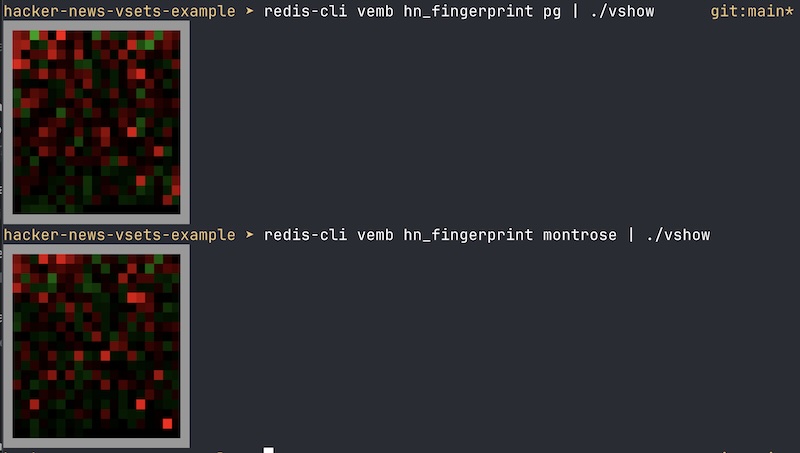
수정 2: tptacek이 이 블로그 글의 HN 제출 댓글에서 지적했듯이 결과가 의심스러워 보이는(의미 없어 보이는) 경우를 위해, 예를 들어 montrose와 pg가 단어 사용 패턴에서 실제로 얼마나 유사한지를 보여주는 ‘시각적’ 매칭을 하나 소개한다:
댓글
로그인하고 댓글 남기기