Rust와 WebAssembly로 만든 작고 정적인 풀텍스트 검색 엔진
원문은 Matthias Endler님이 에 게재했습니다. 이 블로그 구독하기
정적 웹사이트에 추가할 수 있는 기본적인 검색 모듈을 만들었습니다. 매우 가볍고(gzip 압축 시 50kB~100kB) Hugo, Zola, Jekyll에서 동작합니다. 전체 단어 검색만 지원합니다. 데모는 왼쪽 검색창에서 확인해 보세요. 코드는 GitHub에 있습니다.
정적 사이트 생성기는 마법 같습니다. 성능을 희생하지 않으면서 동적 콘텐츠의 장점을 모두 결합하죠.
그동안 이 블로그는 Jekyll, Cobalt을 거쳐 최근에는 Zola로 운영되어 왔습니다.
하지만 제가 항상 아쉬웠던 점은 정적 웹사이트에는 ‘정적’ 검색 엔진이 함께 제공되지 않는다는 것이었습니다. 대신 사람들은 커스텀 Google 검색이나 Algolia 같은 외부 검색 엔진, 혹은 lunr.js나 elasticlunr 같은 순수 JavaScript 기반 솔루션에 의존합니다.
이들은 대부분 사이트에서 잘 동작하지만, 최종적인 해답처럼 느껴진 적은 없습니다.
Google에 대한 의존성을 하나 더 추가하고 싶지 않았고, 지연 시간을 늘리고 독점적인 Algolia 같은 독립 웹 백엔드를 쓰고 싶지도 않았습니다.
반면 저는 JavaScript에 크게 의존하는 웹사이트도 그다지 좋아하지 않습니다. 예를 들어 lunr가 생성하는 검색 인덱스만 해도 수 메가바이트에 달할 수 있습니다. 오늘날 대역폭 기준으로도 사치스럽게 느껴집니다. 게다가 JavaScript 파싱 자체도 여전히 시간이 오래 걸립니다.
저는 다른 정적 콘텐츠와 함께 배포할 수 있는 단순하고 가볍고 자체 완결적인 검색을 원했습니다.
그래서 아예 블로그에 검색 기능을 추가하지 않았습니다. 아티클이 점점 늘어나면서 원하는 콘텐츠를 찾기가 점점 더 어려워지는데, 안타까운 일이죠.
아이디어
아주 오래전인 2013년에 “Writing a full-text search engine using Bloom filters”라는 글을 읽었는데, 정말 눈이 번쩍 뜨였습니다.
아이디어는 단순했습니다. ✨Bloom Filter✨라는 마법 같은 자료구조를 이용해 작고 자체 완결적인 검색 인덱스를 생성하는 제너레이터에 제 블로그 아티클을 모두 통과시키자는 것이었습니다.
잠깐, Bloom Filter가 뭔가요?
Bloom filter는 어떤 원소가 집합에 속해 있는지 공간 효율적으로 확인하는 방법입니다.
핵심은 원소 자체를 저장하지 않는다는 점입니다. 다만 이전에 저장된 적이 있다는 것을 어느 정도 확신을 가지고 알 수 있을 뿐입니다. 우리의 경우 특정 error rate로 어떤 단어가 아티클에 들어 있다고 말할 수 있습니다.

다음은 원문에서 각 포스트마다 Bloom filter를 생성하는 Python 코드입니다(Stavros Korokithakis 제공):
filters = {}
for name, words in split_posts.items():
  filters[name] = BloomFilter(capacity=len(words), error_rate=0.1)
  for word in words:
    filters[name].add(word)
무시해도 될 수준의 오탐(false positive)을 허용하는 error_rate 덕분에 메모리 사용량을 극도로 작게 유지할 수 있습니다.
홈페이지에 바로 이런 것이 필요하다는 걸 직감했습니다. Bloom filter와 검색 엔진을 브라우저로 직접 전달하자는 아이디어였습니다. 마침내 백엔드 없이 작고 정적인 검색을 가질 수 있게 되는 거죠!
골치 아픈 문제들
환상은 금방 깨졌습니다.
생성된 Bloom filter를 어떻게 번들링하고 최소화해야 할지, 클라이언트에서 어떻게 실행해야 할지 전혀 감이 없었습니다. 원문에서는 이 부분을 간략하게 언급합니다:
클라이언트 측에 Bloom filter 알고리즘을 구현해야 합니다. 역색인 검색 알고리즘보다 크게 길지는 않겠지만, 그래도 조금 더 복잡할 겁니다.
제 JavaScript 실력으로는 이를 해낼 자신이 없었습니다. 2013년 당시 NPM은 나온 지 3년밖에 안 됐고 WebPack은 갓 1년이 된 시점이라, 기존 솔루션을 어디서 찾아야 할지도 몰랐습니다.
다음에 무엇을 해야 할지 몰라 제 아이디어는 한낱 꿈으로 남았습니다.
새로운 희망
5년 뒤인 2018년, 웹은 완전히 달라져 있었습니다. 번들러는 어디에나 있었고 Node 생태계는 번성하고 있었습니다. 특히 한 가지가 작고 정적인 검색 엔진에 대한 꿈을 다시 살려냈습니다. 바로 WebAssembly였습니다.
WebAssembly(줄여서 Wasm)는 스택 기반 가상 머신을 위한 바이너리 명령어 형식입니다. Wasm은 C/C++/Rust 같은 고급 언어를 컴파일하기 위한 이식 가능한 타깃으로 설계되어, 클라이언트와 서버 애플리케이션을 웹에 배포할 수 있게 합니다. [출처]
이는 제가 익숙한 언어로 클라이언트 측 코드를 작성할 수 있다는 의미였습니다. 바로 Rust로요! 🎉
제 여정은 2018년 1월의 프로토타입에서 시작됐습니다. 위 Python 버전을 그대로 포팅한 것이었습니다:
let mut filters = HashMap::new();
for (name, words) in articles {
  let mut filter = BloomFilter::with_rate(0.1, words.len() as u32);
  for word in words {
    filter.insert(&word);
  }
  filters.insert(name, filter);
}
각 아티클에 대한 Bloom filter를 만드는 데는 성공했지만, 여전히 이를 웹용으로 패키징하는 방법은 전혀 몰랐습니다. 그러다 2018년 2월에 wasm-pack이 등장했습니다.
이런! Rust 코드를 브라우저에 배포해 버렸네요.
이제 퍼즐 조각이 모두 맞춰졌습니다:
- Rust — 제가 편하게 다루는 언어
- wasm-pack — WebAssembly 모듈용 번들러
- 개념 증명 역할을 한 동작하는 프로토타입
이 페이지 왼쪽에서 보이는 검색창이 그 결과물입니다. WebAssembly를 이용해 Rust로 완전히 동작합니다(일명 RAW 스택). 원하시면 지금 바로 시도해 보세요.
그 과정에서 꽤 많은 장애물이 있었습니다.
Bloom Filter 크레이트
Bloom filter를 구현한 몇몇 Rust 라이브러리(크레이트)를 살펴봤습니다.
먼저 jedisct1의 rust-bloom-filter를 시도했지만, 타입이 Serialize/Deserialize를 구현하지 않았습니다. 그래서 생성한 Bloom filter를 바이너리 안에 저장했다가 클라이언트 측에서 불러올 수 없었습니다.
몇 가지를 더 시도한 끝에 직렬화를 지원하는 cuckoofilter 크레이트를 찾았습니다. 동작 방식은 Bloom filter와 비슷하지만, 차이점이 궁금하다면 이 요약을 참고하세요.
사용법은 다음과 같습니다:
let mut cf = cuckoofilter::new();

// Add data to the filter
let value: &str = "hello world";
let success = cf.add(value)?;

// Lookup if data was added before
let success = cf.contains(value);
// success ==> true
cuckoo filter를 사용해 블로그 아티클 10개에 대한 필터를 번들링했을 때 출력 크기를 확인해 보겠습니다:
~/C/p/tinysearch ❯❯❯ l storage
Permissions Size User    Date Modified Name
.rw-r--r-- 44k mendler 24 Mar 15:42 storage44kB는 나쁘지 않아 보이지만, 이는 10개 아티클에 대한 cuckoo filter를 Rust 바이너리로 직렬화한 크기일 뿐입니다. 여기에 검색 기능과 헬퍼 코드를 더해야 합니다. 기본 wasm-pack을 사용했을 때 클라이언트 측 코드 전체는 216kB였습니다. 너무 큽니다.
바이너리 크기 줄이기
초기 프로토타입에서 216kB라는 충격적인 첫 결과를 보고, 바이너리 크기를 줄일 방법을 찾아봤습니다.
첫 번째는 johnthagen의 Rust 바이너리 크기 최소화 조언을 따르는 것이었습니다.
Cargo.toml에 몇 가지 옵션을 설정하면 꽤 많은 바이트를 줄일 수 있습니다:
"opt-level = 'z'" => 249665 bytes
"lto = true"      => 202516 bytes
"opt-level = 's'" => 195950 bytesopt-level을 s로 설정하면 속도를 크기와 맞바꾸는 셈이지만, 어차피 우리는 당장 최소 크기에 더 관심이 있습니다. 어쨌든 다운로드 크기가 작으면 성능도 좋아지니까요.
다음으로 .wasm 코드 크기를 작게 만드는 대체 Rust 할당자인 wee_alloc을 시도해 볼 수 있습니다.
이는 초기에 소수의 동적 크기 할당을 수행한 뒤 추가 할당 없이 본격적인 작업을 수행하는 코드를 위한 것입니다. 이 시나리오에서는 할당자가 필요하긴 하지만, 할당 성능을 작은 코드 크기와 기꺼이 맞바꿀 수 있습니다.
정확히 우리가 원하는 것입니다. 시도해 보겠습니다!
"wee_alloc and nightly" => 187560 bytes바이너리에서 4%를 더 줄였습니다.
호기심에 codegen-units를 1로 설정해 봤습니다. 코드 생성에 단일 스레드만 사용한다는 의미입니다. 놀랍게도 바이너리 크기가 약간 더 작아졌습니다.
"codegen-units = 1" => 183294 bytes그러다 binaryen이라는 Wasm 최적화 도구를 알게 됐습니다. macOS에서는 homebrew로 설치할 수 있습니다:
brew install binaryen이 도구는 wasm-opt라는 바이너리를 제공하며, 덕분에 15%를 더 줄일 수 있었습니다:
"wasm-opt -Oz" => 154413 bytes그 다음 DOM에 바인딩할 필요가 없으므로 web-sys를 제거했습니다: 152858 bytes.
Wasm 바이너리의 코드 크기를 프로파일링하는 twiggy라는 도구가 있습니다. 다음과 같은 출력을 보여줬습니다:
twiggy top -n 20 pkg/tinysearch_bg.wasm
 Shallow Bytes │ Shallow % │ Item
─────────────┼───────────┼────────────────────────────────
         79256 ┊    44.37% ┊ data[0]
         13886 ┊     7.77% ┊ "function names" subsection
          7289 ┊     4.08% ┊ data[1]
          6888 ┊     3.86% ┊ core::fmt::float::float_to_decimal_common_shortest::hdd201d50dffd0509
          6080 ┊     3.40% ┊ core::fmt::float::float_to_decimal_common_exact::hcb5f56a54ebe7361
          5972 ┊     3.34% ┊ std::sync::once::Once::call_once::{{closure}}::ha520deb2caa7e231
          5869 ┊     3.29% ┊ search
제가 보기에는 바이너리에서 가장 큰 비중을 차지하는 부분이 아티클의 원시 데이터 섹션입니다. 그 다음은 함수 헤더와, 아마도 역직렬화에서 비롯된 float를 decimal로 변환하는 헬퍼 함수들입니다.
마지막으로 WebAssembly 함수 본문을 unreachable로 교체하는 wasm-snip을 시도해 봤습니다. 다음과 같이 실행했지만 코드 크기는 줄지 않았습니다:
wasm-snip --snip-rust-fmt-code --snip-rust-panicking-code -o pkg/tinysearch_bg_snip.wasm pkg/tinysearch_bg_opt.wasmcuckoo filter 파라미터를 조금 조정하고 아티클에서 불용어를 제거한 뒤, 121kB(gzip 시 51kB)까지 줄였습니다. 웹상의 평균 이미지 크기가 약 900kB인 것을 감안하면 나쁘지 않습니다. 게다가 검색 기능은 사용자가 검색 필드를 클릭할 때만 로드됩니다.
업데이트
최근 프로젝트를 cuckoofilter에서 XOR filter로 옮겼습니다. 내장 serde 직렬화를 제공하는 훌륭한 xorf 프로젝트를 사용했는데, 덕분에 커스텀 코드를 많이 제거할 수 있었습니다.
그 덕분에 페이로드 크기를 20~25% 더 줄일 수 있었습니다. 현재 제 블로그에서는 99kB(49kB gzip)까지 줄어들었습니다. 🎉
새 버전은 이미 crates.io에 릴리스되어 있으니 한번 사용해 보세요.
프론트엔드와 글루 코드
wasm-pack은 Wasm과 통신하는 JavaScript 코드를 자동으로 생성해 줍니다.
검색 UI는 w3schools의 JavaScript와 CSS 일부를 커스터마이징했습니다. 키보드 지원도 됩니다! 이제 사용자가 검색어를 입력하면 각 아티클의 cuckoo filter를 순회하며 단어를 매칭합니다. 결과는 히트 수에 따라 점수가 매겨집니다. 이 부분을 추가해 준 소중한 동료 Jorge Luis Betancourt에게 감사드립니다.
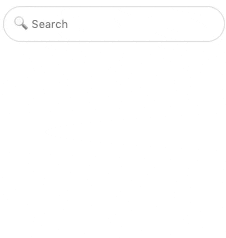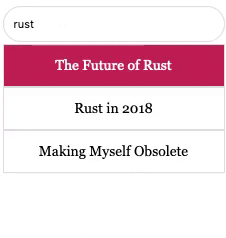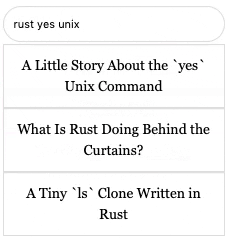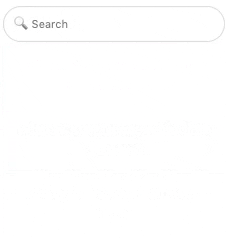
(재미있는 사실: 이 애니메이션은 압축되지 않은 Wasm 검색 자체와 크기가 거의 같습니다.)
주의 사항
전체 단어만 매칭됩니다. 접두사 검색도 추가하고 싶지만, 시도했을 때 바이너리가 너무 커졌습니다.
사용법
Wasm 파일을 생성하는 독립 실행형 바이너리는 tinysearch라고 합니다. 입력으로 JSON 파일 경로 하나를 받습니다:
tinysearch path/to/corpus.json이 corpus.json에는 인덱싱하려는 텍스트가 들어 있습니다. 형식은 매우 간단합니다:
[
  {
    "title": "Article 1",
    "url": "https://example.com/article1",
    "body": "This is the body of article 1."
  },
  {
    "title": "Article 2",
    "url": "https://example.com/article2",
    "body": "This is the body of article 2."
  }
]
이 JSON 파일은 어떤 정적 사이트 생성기로든 만들 수 있습니다. Zola용 제 버전은 다음과 같습니다:
{% set section = get_section(path="_index.md") %}

[
  {%- for post in section.pages -%}
    {% if not post.draft %}
      {
        "title": {{ post.title | striptags | json_encode | safe }},
        "url": {{ post.permalink | json_encode | safe }},
        "body": {{ post.content | striptags | json_encode | safe }}
      }
      {% if not loop.last %},{% endif %}
    {% endif %}
  {%- endfor -%}
]
Jekyll 버전도 거의 비슷할 겁니다. 시작점으로 참고할 만한 자료는 여기 있습니다. 정적 사이트 생성기용으로 동작하는 무언가를 만들었다면 알려 주세요.
느낀 점
- 아직은 황무지와 같습니다. 불안정한 기능, nightly Rust, 문서가 거의 매일 outdated됩니다.
단단히 마음먹고 덤비세요! - 좋은 아이디어를 제품으로 만드는 것은 많은 노력이 듭니다. 사용 편의성, 범용성, 유지보수성, 문서화 등 여러 요소를 신경 써야 합니다.
- Rust는 데드 코드를 제거하는 데 매우 뛰어나서 보통 사용하지 않는 것에 대해서는 비용을 치르지 않습니다. 그래도 Wasm 바이너리에 추가하는 의존성에 대해서는 매우 보수적으로 접근하라고 조언하고 싶습니다. 필요 없는 기능을 추가하고 싶은 유혹이 들고, 그러면 바이너리 크기가 늘어나기 때문입니다. 예를 들어 테스트 중에 StructOpt를 사용했고, 이 커맨드라인 인수를 파싱하는
main()함수가 있었습니다. 이는 Wasm에는 필요 없었기 때문에 나중에 제거했습니다. - 모두가 Rust 코드를 작성하고 싶어 하지는 않는다는 걸 이해합니다. 시작하기가 복잡하지만, 멋진 점은 거의 어떤 다른 언어도 사용할 수 있다는 것입니다. 예를 들어 Go 코드를 작성해 Wasm으로 트랜스파일할 수도 있고, PHP나 Haskell을 선호할 수도 있습니다. 이미 많은 언어가 지원됩니다.
- 많은 사람들이 WebAssembly를 장난감 기술로 치부합니다. 사실과는 한참 거리가 멉니다. 제 생각에 WebAssembly는 웹과 그 너머를 위한 제품을 만드는 방식을 혁신할 것입니다. 불과 2년 전만 해도 매우 어려웠던 일, 즉 어떤 언어로 작성된 코드든 모든 브라우저로 배송하는 일이 이제는 쉬워졌습니다. 앞으로가 정말 기대됩니다.
- 회사 웹사이트용 독립형 자체 호스팅 검색 인덱스를 찾고 있다면 sonic을 확인해 보세요. 대안으로 stork도 살펴보세요.
직접 써 보세요!
다음 제한 사항을 유념해 주세요:
- 전체 단어만 검색됩니다. 검색 제안 기능은 없습니다. 접두사 검색을 하면 멘토스와 다이어트 콜라처럼 바이너리 크기가 폭발하기 때문입니다.
- 모든 아티클의 검색 인덱스를 하나의 정적 바이너리로 묶기 때문에, 소규모에서 중규모 웹사이트에만 사용할 것을 권장합니다. 아티클당 약 4kB(압축 전) 정도로 예상하세요.
현재 컴파일 시간이 끔찍합니다(제 머신에서 새로 설치 후 약 1.5분). 주로 인덱스를 다시 빌드할 때마다 Rust 크레이트를 처음부터 컴파일하기 때문입니다.
업데이트: CephalonRho의 멋진 작업 덕분에 PR #13에서 대부분 수정되었습니다. 다시 한번 감사드립니다!
최종 Wasm 코드는 검색 서버까지의 왕복을 아낄 수 있어 엄청나게 빠릅니다. 즉각적인 피드백 루프는 포스트를 검색한다기보다 목록을 필터링하는 느낌에 가깝습니다. 완전히 오프라인에서도 동작할 수 있어 앱과 함께 번들링하고 싶을 때 유용할 수 있습니다.
댓글
로그인하고 댓글 남기기