Hacker Newsの文体フィンガープリントを再現する
原文は Salvatore Sanfilippo により に公開されました。 このブログを購読する
約3年前、Hacker Newsでとても興味深い投稿を見かけました。学生のChristopher Tarry氏が、コメント中の上位単語の出現頻度ベクトルに対してコサイン類似度を用いることで、似たHNアカウントを検出し、ときには同一人物が実際に操作している別アカウント、つまり書き手の正体を隠すために使われるフェイクアカウントまで突き止めてみせたのです。
元の投稿はこちらです: https://news.ycombinator.com/item?id=33755016
当時の私は、文体検出のためのBurrows-Delta法を知りませんでした。上位単語の頻度ベクトルを正規化するだけで、これほど驚くべき結果が得られるなんて、なんだか魔法のように思えたのです。Wikipediaのページをいくつか読んで、頭の片隅に留めておきました。その後、RedisのVectorsに取り組んでいるときにこの投稿を思い出し、ウェブで検索してみたところ、元のページはすでに消えており、作者が元の投稿やウェブサイトで、データがどのように処理されたのか、上位単語がどのように抽出されたのか(そして特に、何語が使われたのか)などをあまり詳しく説明していないことに気づきました。主要な作業が終わったら、Vector Setsでこの研究を再現してみようと考えました。今では新しいデータ型がリリース候補版に入り、この問題に取り組む時間ができたのです。以下は私がやったことのレポートですが、その前に、お決まりのデモサイトを紹介します。次のリンクから試すことができます:
https://antirez.com/hnstyle?username=pg&threshold=20&action=search
注: データセットは700MBのRAMを消費するため、私の小さなサーバーでは、今後数か月のうちに公開を終了するかもしれません。ただし、この記事の後半で、すべてを一から再現するためのリンクとGitHubリポジトリを紹介しています。
追記2: ウェブサイトが持ちこたえてくれることを願っています。とても粗削りなPythonスクリプトで動いているからです。こんな小さなサーバーでもVSIMコマンドをベンチマークしてみたところ、なんと毎秒8万回のVSIMを処理できました! int8量子化と、その他いくつかの最適化のおかげです。ただ、Pythonスクリプトの出来はひどいもので、毎回新しいRedis接続を作るなどしています。うまくいくことを祈るばかりです。
生データのダウンロードと処理
さて、こういったことをやろうとして最初に直面した問題は、Hacker Newsのコメントのアーカイブを見つけることでした。幸い、HNの開始当初から2023年までに投稿されたものがすべて含まれていると思われるアーカイブがあり、合計で10GBもの巨大なデータでした。こちらから入手できます: https://huggingface.co/datasets/OpenPipe/hacker-news 正直なところ、これがスクレイピングで取得されたものなのか、HNが何らかの形でこのデータを公開しているのかはよく分かりません。
私は少なくとも公開データセットに関してはバイナリファイルがあまり好きではないので、Parquetファイルをより小さく扱いやすいものに変換するために、2つのPythonスクリプトを使いました。1つ目のスクリプト gen-top-words.py は、バイナリファイルを受け取って、データセット内で使われている上位N単語のリストをtxtファイルとして生成します。デフォルトでは1万語を生成しますが、統計分析に必要なのはもっと少数です(というより、実際には単語を使いすぎると、文体ではなく、ユーザーが語っている内容のトピックを捉えてしまうのです!)。そしてもう1つのPythonスクリプトが、ユーザーごとにすべてのコメントを集計し、非常に大きなJSONLファイルを生成します。そこには2つのキーだけが含まれます。ユーザー名と、そのユーザーがHNの開始から2023年までの全履歴で使ったすべての単語の頻度テーブルです。各エントリは次のようになります:
{"by": "rtghrhtr", "freqtab": {"everyone": 1, "hates": 1, "nvidia": 1, "but": 1, "treats": 1, "ati": 1, "as": 1, "an": 1, "afterthought": 1, "another": 1, "completely": 1, "useless": 1, "tool": 1, "to": 1, "throw": 1, "on": 1, "the": 1, "pile": 1}}この段階で、最後のスクリプト insert.py が本当の仕事を担います。各ユーザーに対してBurrows法を適用し、ユーザーの文体ベクトルを作成してRedisに挿入するのです。ファイルの事前処理(時間のかかる作業)をしておく利点は、挿入スクリプトを異なるパラメータ(特に使用する上位単語の数)でより手軽に呼び出し、Parquetファイルを毎回再処理することなく、より素早く異なる結果を確認できることです。
Burrows法はどのように動くのか?
元の投稿でChristopherは、単語の使用頻度を正規化してコサイン類似度を適用すればよいと書いていました。実際には、プロセスはもう少し複雑です。まず、この手法が本質的にどのように機能するのかを考えてみましょう。特定のユーザーが、期待される「平均的」な言語使用と比べて、特定の単語を使いすぎているか、あるいは使わなさすぎているかを捉えようとするものです。そのために、実際には(Pythonコードから)次のようなステップを踏みます。
上位単語のそれぞれについて行う処理は次のとおりです:
# Convert to relative frequency
rel_freq = frequency / total_words

# Standardize using z-score: z = (freq - mean) / stddev
mean = word_means.get(word, 0.0)
stddev = word_stddevs.get(word, 1.0)  # Default to 1.0 to avoid division by zero

z_score = (rel_freq - mean) / stddev

# Set the z-score directly in the vector at the word's index
vector[word_to_index[word]] = z_score
つまり、まずユーザーが特定の単語を使った頻度を、その単語の*全体的な*使用頻度を差し引くことで「中心化」します。こうすることで、そのユーザーがその単語をどれだけ少なく(負の値)あるいは多く(正の値)使ったかを示す数値が得られます。しかし、考えてみると、異なる書き手の間でばらつきがはるかに大きい単語は、変動しても重要度が低くなります。私たちは、その単語の通常のばらつきと比べて、このユーザーがはるかに大きく使いすぎ/使わなさすぎている単語のシグナルを増幅したいのです。そのため、中心化した頻度を、その単語の全体的な標準偏差で割ります。これで「zスコア」と呼ばれるものが得られます。ある単語がどちらかの方向にどれだけ外れ値であるかを示す調整済みの指標です。
これで、RedisのVector Setに次のように挿入する準備ができました:
VADD key FP32 [blob with 350 floats] username(Vector Setsの詳細については、こちらのドキュメントを参照してください -> https://github.com/redis/redis/blob/unstable/modules/vector-sets/README.md)
Redisは挿入されたベクトルをL2正規化しますが、VEMBで関連するベクトルを取得する際に値を元に戻せるようL2の値も記憶しているため、z_scoreはそのまま設定されました。
最後に、VSIMを使えば似たユーザーを取得できます:
127.0.0.1:6379> vsim hn_fingerprint ele pg
 1) "pg"
 2) "karaterobot"
 3) "Natsu"
 4) "mattmaroon"
 5) "chc"
 6) "montrose"
 7) "jfengel"
 8) "emodendroket"
 9) "vintermann"
10) "c3534l"
すべてのコード(ウェブアプリ自体を除く)はこちらにあります: https://github.com/antirez/hnstyle
READMEファイルに、すべての部分を再現する方法が説明されています。
なぜ350語なのか?
このブログ投稿のきっかけとなった元の投稿で欠けていたことの一つが、上位何語を使うべきかという点です。単語を使いすぎると、私のRedisに関するコメントが大量に引っかかってしまいます。Redisは使用頻度上位1万語の中に入っているからです。なんと、私は最初まさにこの間違いを犯し、VSIMは似た*文体*のユーザーではなく、私と似たトピックについて話しているユーザーを返し続けました。しかし幸いなことに、Internet Archiveが「pg」アカウントに関するChristopherの結果をキャッシュしていました。こちらです:
https://web.archive.org/web/20221126235433/https://stylometry.net/user?username=pg
そこで、上位k語を調整して同様の結果が得られるようにしました。また、原論文を読んで驚いたのですが、分析をうまく機能させるにはわずか150語でも十分だということが分かりました。そして一般的には150〜500語の範囲が最適とされています。
警告: ユーザーを検索したときに、見つかるのが主にフェイクアカウントだと思わないでください。多くのフェイクアカウントはデータが少なすぎます。使い捨てアカウントを作って数件コメントを残しただけで終わることが多いからです。そのため、特定のユーザーの文体に関連付けられるアカウントのほとんどは、単に文体が似ている別の人々ということになります。この手法は、誰がネイティブスピーカーで誰がそうでないかを区別するのに非常に強力だと私は考えています。これは下のベクトルの可視化から特に明らかです。
検証と可視化…
私が再現したもう一つのこと(これも元投稿者のアイデアです)は、同じユーザーを antirez_A と antirez_B のように2つのバリエーションで挿入し、それぞれ異なるコメントセットを使うというものでした。そして、antirez_A に似たユーザーを問い合わせたときにBが返ってくるかを確認するのです。実際、テストした*ほとんどの*ユーザーでこれは非常によく機能し、しばしばトップの結果として返ってきました。つまり、私たちの手法が実際に機能していることが分かります。
しかし、ベクトルから文体をこれほど簡単に「見る」ことができるのなら、肉眼ではどうでしょうか? 最近、私はターミナルをGhosttyに切り替えました。GhosttyはKittyのグラフィックスプロトコルをサポートしており、ターミナルウィンドウ内に直接ビットマップを表示できます。ずっと前からこれで遊んでみたいと思っていました。ようやく試す良い理由ができたのです。
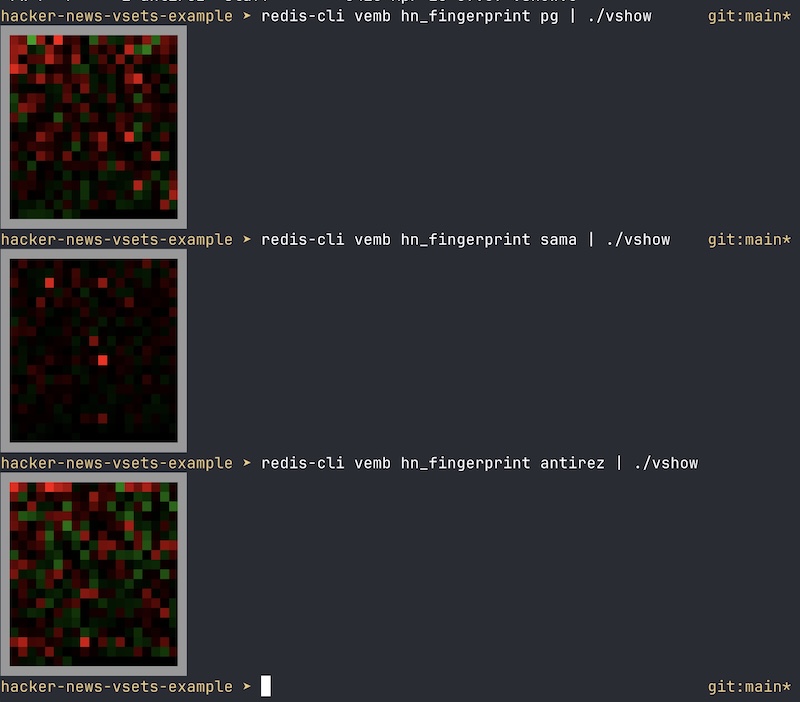
上で起きているのは、floatのリスト(ベクトル)を返すVEMBコマンドを呼び出しているということです。そして、リポジトリに含まれるvshowユーティリティが、ベクトルを収めるのに必要な最小の正方形を見つけ、正の値を赤、負の値を緑で表示します。
ご覧のとおり、非ネイティブスピーカーである私は、非常に単純な単語を使いすぎ、洗練された単語を使わなさすぎています。他の著者は特定の単語を強調し、また別の著者ははるかに「プレーン」で、アーティファクトが少なくなっています。あるとき、私はそこで実際に何が起きているのか気になりました。自分が使いすぎ、あるいは使わなさすぎている単語は何なのか? そこで、デモウェブサイトではユーザーを分析するボタンを押すことで、使いすぎている上位10語と使わなさすぎている上位10語を見ることもできます。まあ、私のいくつかは間違いなく英語の文法に関する問題が原因です :D
さて、この調査はこの辺で終わりにしましょう! Vector SetsはRedis 8 RC1に入り、私にはまだやるべきことがありますが、これは楽しかったですし、ベクトルがAI以前から間違いなくクールだったことを示していると思います。こんなに長い投稿を読んでいただき、ありがとうございました。
追記: insert.pyスクリプトは、ユーザーが書いた総単語数をJSONメタデータとしても挿入することを言い忘れていました。そのため、FILTERを使って、特定の単語数の範囲に一致するものだけを表示することができます。これは、しばしば身元を隠す必要があるときにだけ稀に使われる重複アカウントを検出するのに役立ちます:
127.0.0.1:6379> vsim hn_fingerprint ele pg FILTER ".wordcount < 10000"
 1) "montrose"
 2) "kar5pt"
 3) "ryusage"
 4) "corwinstephen"
 5) "ElfinTrousers"
 6) "beaned"
 7) "MichaelDickens"
 8) "bananaface"
 9) "area51org"
10) "william42"
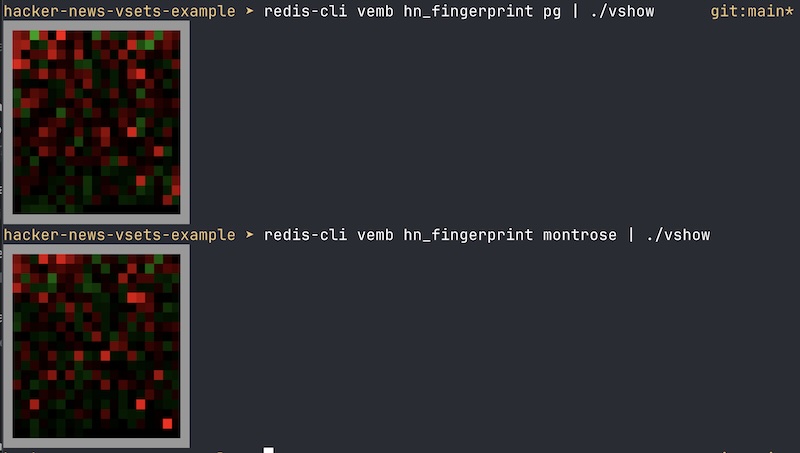
追記2: もしマッチ結果が疑わしく(無意味に)見える場合、tptacek氏がこのブログ投稿のHNへの投稿のコメントで指摘していたように、例えばmontroseとpgが単語の使用パターンにおいて本当にどれだけ似ているかを示す「視覚的な」マッチをこちらに示します:
コメント
ログインしてコメントする