Go製Webアプリのメモリ枯渇バグを修正した話
原文は Michael Lynch により に公開されました。 このブログを購読する
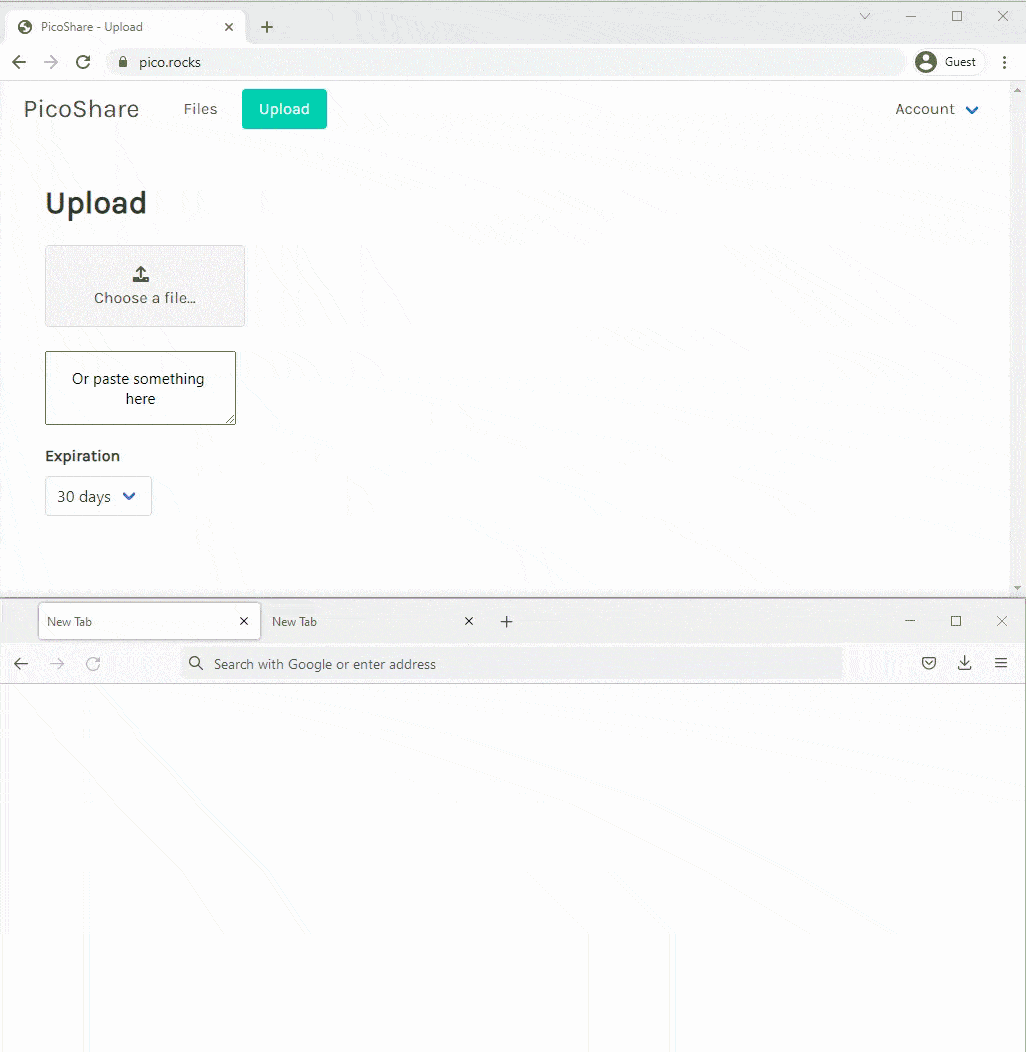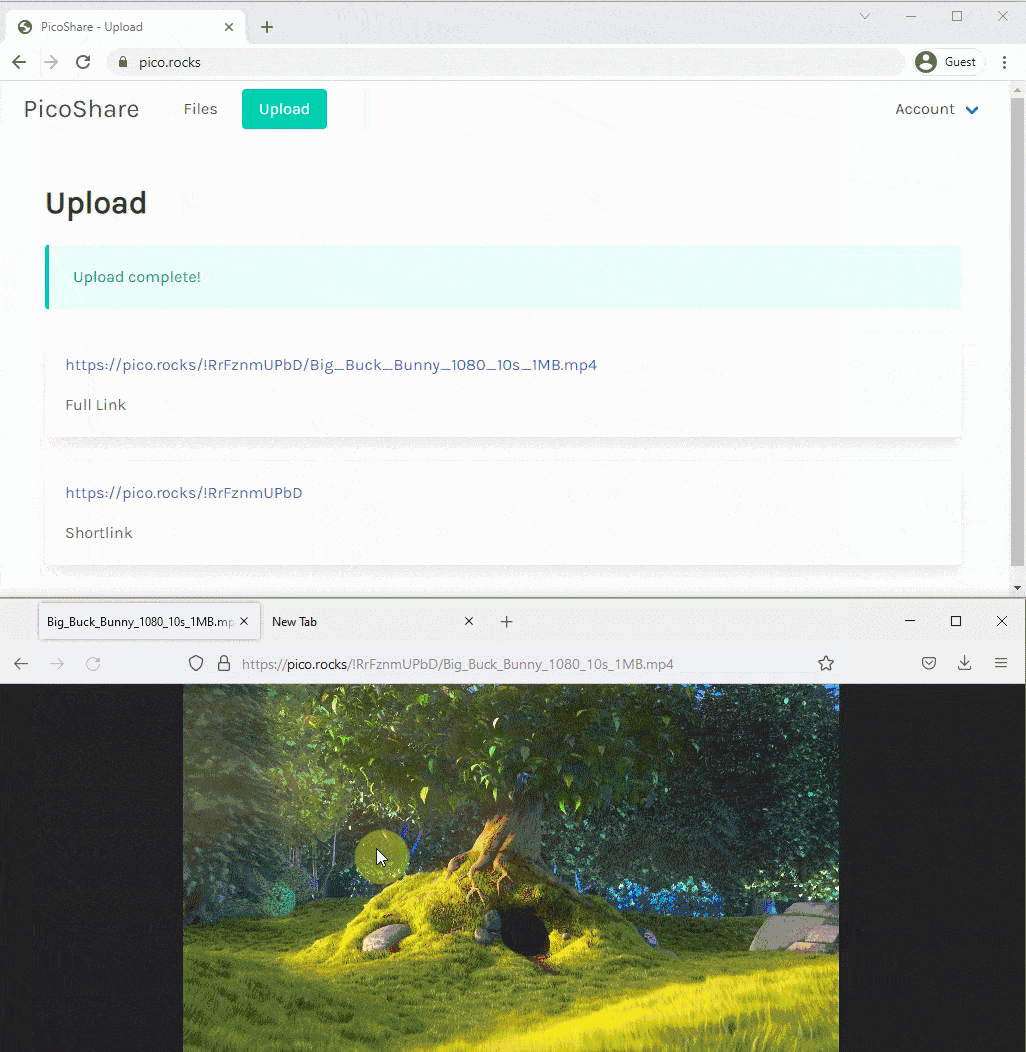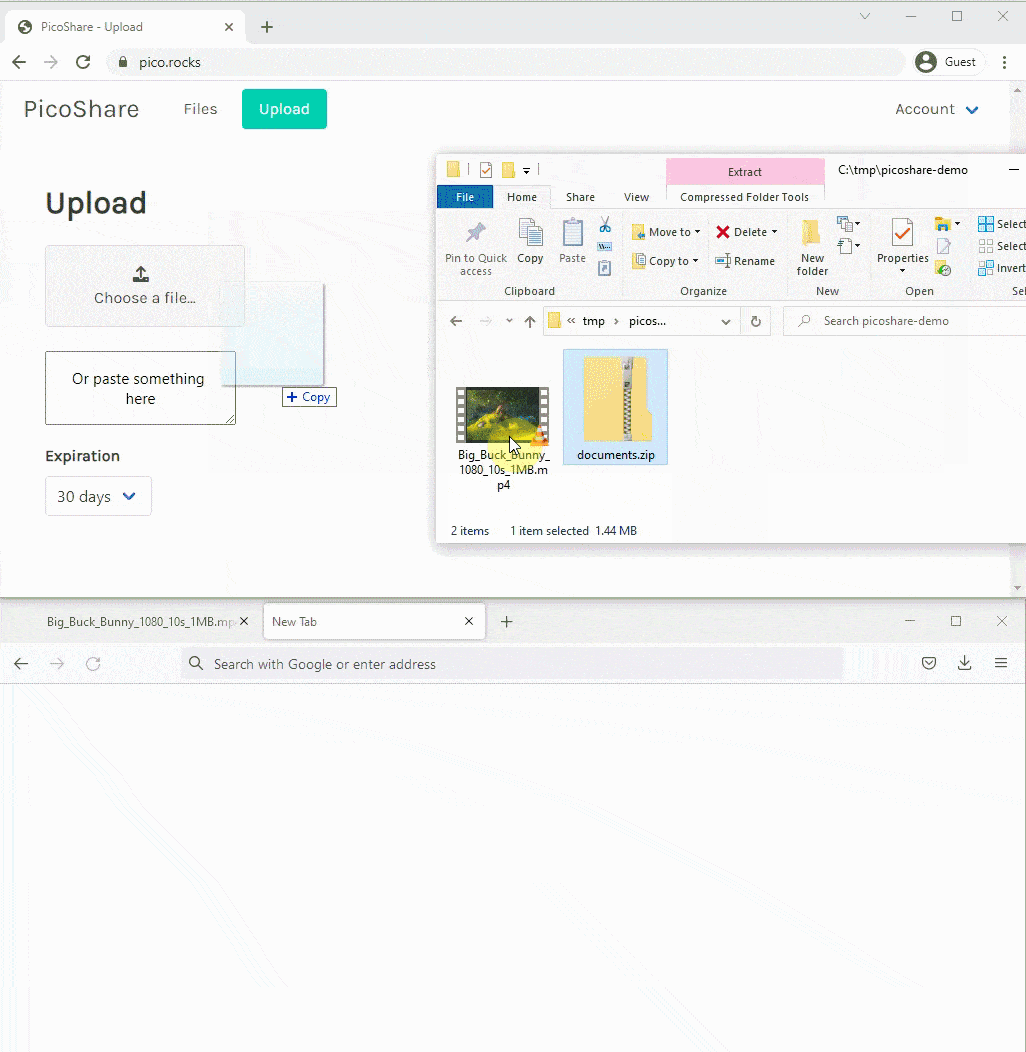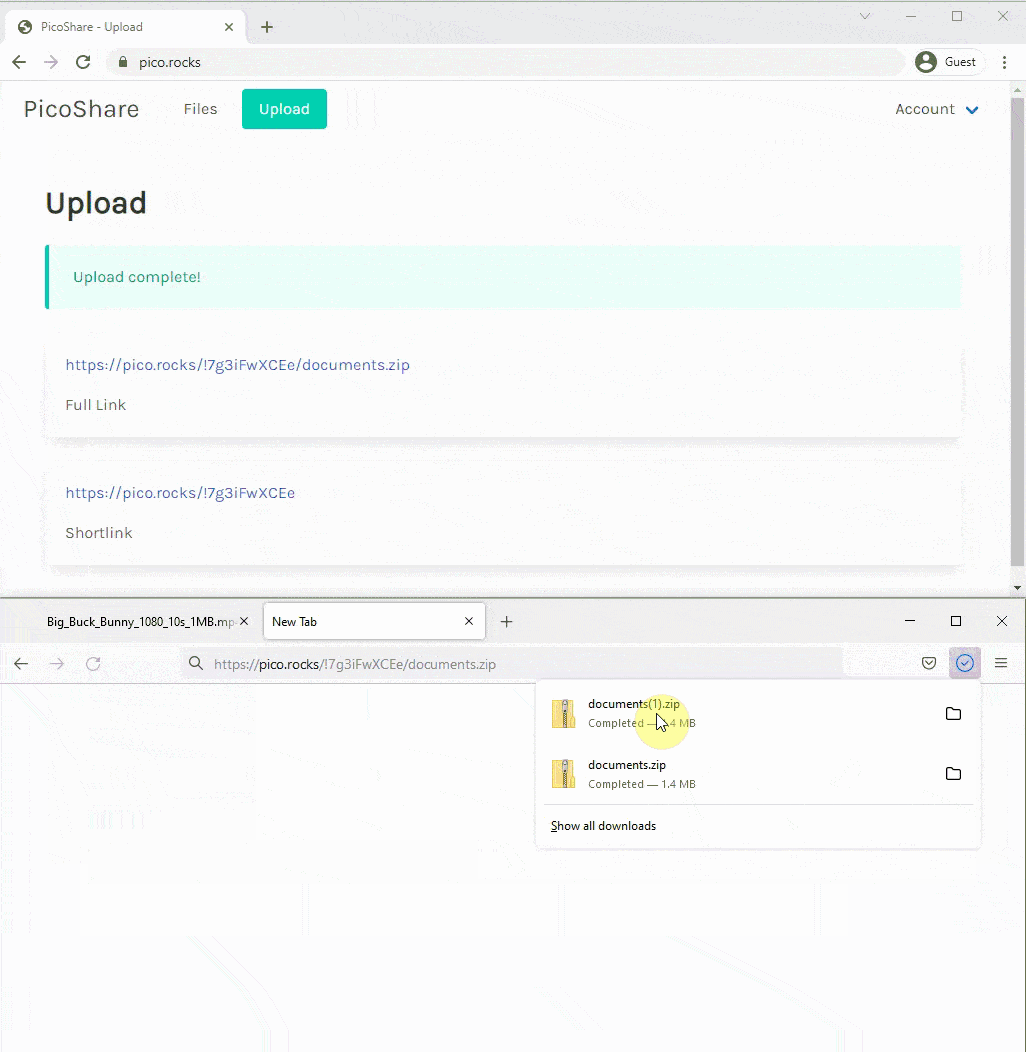
今年の初め、私はPicoShareというオープンソースアプリを作りました。ファイルを共有するためのシンプルなGo製Webアプリです。メール添付には大きすぎるけれど、受取人にDropboxやGoogle Driveを使わせたくないファイルを送るために使っています。
数ヶ月前、PicoShareサーバーが数日おきに落ちるようになりました。ログを確認すると、メモリ不足のエラーが出ていました。

クラッシュをデバッグする時間がなかったので、とりあえずサーバーのメモリを512MBから1GBに増やしました。それでもクラッシュが続いたので、さらに2GBまで増やしました。
RAMを積み増すだけでクラッシュをごまかすのは気持ちの良い解決策ではありません。そこでこの2週間、クラッシュのデバッグに取り組み、その進捗をTwitterで共有してきました。
現時点で、クラッシュの原因となっていた問題はすべて修正し、その過程でGoやSQLite、デバッグについて多くの有益な教訓を得ることができました。
事の経緯をリアルタイムで追いたい方はTwitterのスレッドをご覧ください。整理された要約を読みたい方は、この先を読み進めてください。
前置き:私はSQLiteを奇妙な方法で使っている
PicoShareで私が下した奇妙なアーキテクチャ上の判断の一つは、すべてのファイルデータをSQLiteに保存していることです。これは通常とは異なる選択です。Webアプリケーションでは通常、ファイルのアップロードはデータベースではなくファイルシステムに直接保存するからです。アップロードされるファイルのサイズが際限なく大きくなる可能性がある場合はなおさらです。
ファイルデータをSQLiteに書き込む利点は、PicoShareのアプリケーションの状態がすべて単一のデータベースに収まることです。それ自体は特別なことではありませんが、私はPicoShareがLitestreamと連携するように設計しました。LitestreamはSQLiteデータベースをクラウドストレージにレプリケートするツールです。Litestreamのおかげで、PicoShareはバックアップとリストアを実質「タダ」で手に入れています。サーバーを完全に吹き飛ばしてどこにでも再デプロイしても(別のクラウドプロバイダーでさえ)、PicoShareはまったく同じ状態で復活し、同じファイルを配信し続けます。
デバッグの過程
エラーの再現
PicoShareのクラッシュは数日に一度しか起きなかったので、最初のステップはクラッシュをより速く強制的に再現する方法を見つけることでした。
メモリがわずか256MBのFlyインスタンスにPicoShareをデプロイし、大きなファイルをアップロードすることでエラーを再現できました。テストには短編映画Big Buck Bunnyの高解像度版を使い、サイズは269MBから618MBのものを使いました。

大きなアップロードをテストするのに十分なサイズだったので、短編映画Big Buck Bunnyをテストファイルとして使いました。
618MB版を2つ並行してアップロードすると、1分ほどで一貫してPicoShareがメモリ不足エラーで落ちました。
プロファイリングツールでメモリ肥大化を特定する
調査の最初のブレークスルーは、Litestreamの作者であり最近Flyのチームに加わったBen Johnsonからもたらされました。Benは、たった1行のコードがPicoShareに大量のRAMを消費させていたことを説明する詳細なプルリクエストを作成してくれました。
Benはプロファイリングに豊富な経験があるので、新しいユニットテストを作成し、テスト後にメモリをプロファイルすることで問題を再現できました。後にBenは同じ情報を得るより簡単な方法を教えてくれましたが、ここではそちらを紹介します。Benの元の手法はプルリクエストで確認できます。
Goの標準ライブラリには、Webアプリケーションの問題をデバッグするための魔法のようなツールが備わっていることがわかりました。やることは、importにこの1行を追加するだけです。
_ "net/http/pprof"これでアプリを実行すると、多くの有用なデバッグ情報を含む/debug/pprof/というルートが利用できるようになります。

これほど簡単に追加できるとは驚きでした。このWebインターフェースには多くの興味深いデータがありますが、私が使ったのはheapです。使い方は、PicoShareに大きなファイルをアップロードしてから、次のコマンドを実行しました。
go tool pprof \
  -http=:8081 \
  -alloc_space \
  call_tree \
  http://localhost:4001/debug/pprof/heap
するとWebインターフェースが立ち上がり、次のようなグラフが表示されました。

一番下にbytes makeSlice 63.99 MBと書かれた大きな赤いブロックが見えます。これはPicoShareが確保したRAMのうち64MBがGoのmakeSlice関数によるものだという意味です。
makeSliceは私のコードではなくGo標準ライブラリの関数です。どのPicoShareのコードがこのメモリ割り当てを引き起こしたのかを探すため、グラフを上へたどってPicoShareの関数を見つけました。

このチェーンで最後のPicoShareの関数はhandlers.fileFromRequestで、Go標準ライブラリの関数*Request.ParseMultipartFormを呼び出していました。この関数はmultipart形式のHTTPデータをパースする役割を担っており、PicoShareがファイルアップロードを受け取る方法でもあります。
ParseMultipartFormはmaxMemoryパラメータを受け取ります。ドキュメントでは次のように説明されています。
The whole request body is parsed and up to a total of maxMemory bytes of its file parts are stored in memory, with the remainder stored on disk in temporary files.
PicoShareでの呼び出しは次のようになっていました。
r.ParseMultipartForm(32 << 20) // 32 MB32MBという上限を指定していたにもかかわらず、Goは64MBのRAMを確保していました。
BenはmaxMemoryパラメータを1 << 20(1MB)に減らしてみたところ、ParseMultipartFormによるRAM使用量はわずか2.5MBまで下がりました。

これはメモリの大幅な削減だったので、Benが問題を解決してくれたと確信しました。
残念ながら、Benの修正を入れたテスト版をデプロイしても、やはりクラッシュしました。
Benの修正後、PicoShareはクラッシュするまでにより多くの負荷に耐えられるようになったので、効果はあったようです。それでも、大きなファイルを3つ並行してアップロードすると、サーバーは同じメモリ不足エラーで落ちました。
ParseMultipartForm呼び出し後のリソース解放
ググってみて、ParseMultipartFormに関するもう一つの落とし穴を発見しました。
ドキュメントには警告がありませんが、呼び出し側はr.MultipartForm.RemoveAll()を呼び出してParseMultipartForm中にGoが確保したリソースを解放する責任があります。つまり、私はParseMultipartFormを呼ぶたびにメモリリークさせていたのです。
追記(2022-08-11):Damien Neil氏がコメントで、Goはこれらのリソースを自動的にクリーンアップすべきだと指摘しています。GoのHTTP/1実装では自動的にリソースがクリーンアップされており、Damien氏はGoのHTTP/2実装でも一貫して動作するようにバグ修正を提出しています。
リークを修正するため、multipartのリソースをクリーンアップするようにコードを書き直しました。
multipartMaxMemory := 1 << 20 // 1 MiB
if err := r.ParseMultipartForm(multipartMaxMemory); err != nil {
  return err
}
// Free form resources before returning from function.
defer func() {
  if err := r.MultipartForm.RemoveAll(); err != nil {
    log.Printf("failed to free multipart form resources: %v", err)
  }
}()
この修正は有望に見えました。Fly上でリソースを明示的に解放した後、RAM使用量が大幅に減ったのが確認できたからです。

悲しいことに、この修正を入れてもクラッシュは続きました。
ダウンロードの最適化
この頃、Dan WilhelmがTwitterのスレッドをフォローし始めました。彼はGoを使ったことが一度もないにもかかわらず、腕まくりして自分の開発マシンでコードをいじり始めました。
DanはファイルをダウンロードするとRAM使用量が急増することに気づきました。これは奇妙でした。ダウンロードで大量のRAMを消費するはずがないからです。multipartフォームのパースは複雑なのでRAMを肥大化させる要因は多く考えられますが、ファイルの配信はかなり単純なはずです。
PicoShareはすべてのファイルデータをSQLiteに328KBのチャンクで保存しています。いくつかのチャンクをRAMに読み込み、クライアントに送信してからメモリを解放すればいいだけなので、RAMを大量に消費するはずがありません。
DanはデータベースからPicoShareのファイルデータを読み取るコードにバグを見つけました。どこかわかるでしょうか。
func (fr *fileReader) populateBuffer() error {
  if fr.offset == int64(fr.fileLength) {
    return io.EOF
  }

  startChunk := fr.offset / int64(fr.chunkSize)
  stmt, err := fr.db.Prepare(`
      SELECT
        chunk
      FROM
        entries_data
      WHERE
        id=? AND
        chunk_index>=?
      ORDER BY
        chunk_index ASC
      `)
  if err != nil {
    log.Printf("reading chunk failed: %v", err)
    return err
  }
  defer stmt.Close()

  var chunk []byte
  err = stmt.QueryRow(fr.entryID, startChunk).Scan(&chunk)
  if err != nil {
    return err
  }

  // Move the start index to the position in the chunk we want to read.
  readStart := fr.offset % int64(fr.chunkSize)

  fr.buf = bytes.NewBuffer(chunk[readStart:])
  fr.offset += int64(len(chunk)) - readStart

  return nil
}バグはSQLクエリのWHERE句にあります。
WHERE
    id=? AND
    chunk_index>=?
このクエリはファイルデータの1チャンクだけを取得するはずなのに、対象のチャンク以降のすべてを読み込んでしまっていました。
修正は単純に>=を=に変えるだけでした。
WHERE
    id=? AND
chunk_index=?余談:このコードを読んでいて、必要がないのにプリペアドステートメントを使っていたことにも気づきましたが、これがRAMに影響していたとは思いません。
Danの変更はダウンロード側のものだったので、アップロード中に見られたクラッシュが直るとは期待していませんでした。実際その通りでしたが、ダウンロードの配信では劇的なパフォーマンス改善がありました。特に動画や音声のようなストリーミングコンテンツでは、ファイル内の別の位置にシークした際のレスポンスが格段に良くなりました。
SQLiteトランザクションの削除
Twitterのスレッドの中で、何人かがPicoShareのSQLiteトランザクションがRAMを肥大化させている可能性を指摘していました。
PicoShareがファイルデータをSQLiteに書き込む際、私はトランザクションの中で行っていました。目的はデータベースを常に一貫した状態に保つことでした。
トランザクションを使うことで、SQLiteは一部の書き込みが失敗したときにファイルの一部だけがデータベースに残るような状態にならないことを保証します。また、ファイルの内容を書き込まずにファイルのメタデータだけを書き込んだり、その逆が起きたりすることも防げます。
ググってみると、大きなSQLiteトランザクションがメモリ肥大化の原因になりうることがわかったので、試す価値はあると思いました。トランザクションを使わずに変更をすぐにSQLiteにコミットしてみましたが、それでもRAMは肥大化しました。トランザクションが違いを生んでいるようには見えませんでした。
メモリの肥大化は問題ない、クラッシュは困る
この時点で、私は3つの異なる角度からRAM使用量を測っていましたが、それぞれが互いに異なる値を示していました。
- Goのデバッグメトリクスによる割り当て済みメモリ量
- VM内の
htop - VMホスト側のFlyのRAMメトリクス


RAM使用量を測るツールごとに異なる値が表示された
特にFlyのメトリクスは、Goやhtopがほとんど使用量がないと示しているのに、頻繁にRAMが最大まで使われていると表示しました。深掘りすればするほど、RAMの measurements が観測していたクラッシュの挙動から乖離していくので、デバッグには本当に悩まされました。
状況を一変させた洞察はAndrew Ayerからもたらされました。彼は、RAMの肥大化はおそらく見当違いだと指摘しました。

FlyのCEOであるKurt Mackeyがスレッドに現れ、Andrewの仮説を裏付けました。

つまり、Flyのメモリメトリクスにはページキャッシュが含まれていましたが、そのRAMは実行中のアプリケーションが必要とすればVMが再利用するはずだったのです。
これは大きな気づきでした。メモリ不足クラッシュを再現するのが困難だったため、私はRAMの肥大化をクラッシュの近似指標として使っていました。しかし、VMがプロセスを動かし続けるのに十分なメモリを持っている限り、RAMの肥大化自体は問題ではないのです。
ここで私はすべてを再評価する必要がありました。他の修正を却下したとき、それは無害なRAM肥大化が原因だったのか? それとも実際にクラッシュを観測したからだったのか?
SQLiteトランザクションの再検討
Andrew AyerのRAM肥大化についての指摘を踏まえ、PicoShareのSQLiteトランザクションを再検討しました。トランザクションなしの実装を試したとき、クラッシュを見たのか、それとも単なるRAM肥大化を見ただけだったのか、思い出せませんでした。
トランザクションなしの実装をもう一度試してみました。案の定、RAMは肥大化しましたがPicoShareは動き続けました。618MBのファイルを3つ並行してアップロードしても、すべてのアップロードが成功し、PicoShareはHTTPリクエストを処理し続けました。

うまくいった! ついにパフォーマンス問題の根本にたどり着いたと思いました。
そう思ったのも束の間でしたが…
サーバーを一晩放置して翌朝確認すると、同じメモリ不足クラッシュで落ちていました。

SQLiteのVACUUMの廃止
すぐに、夜間のクラッシュはSQLiteのVACUUMコマンドに関連しているのではないかと疑いました。これは未使用のディスク領域を再利用するためにデータベースファイルを圧縮するコマンドです。
クラッシュしたとき、誰もPicoShareサーバーを使っていなかったのですが、PicoShareの定期的なデータベースメンテナンスのタイミングと一致していました。7時間ごとにPicoShareはデータベースから期限切れのエントリを削除し、未使用のディスク領域を再利用するためにVACUUMを実行しています。
サーバーでVACUUMコマンドを実行してテストしたところ、確かにメインの.dbファイルのサイズは減りましたが、SQLiteのライトアヘッドログのサイズが増加していました。

この時点で、BenがそもそもなぜVACUUMが必要なのかと尋ねてきました。
たしかに、なぜ私はそんなことをしているんだろう?
PicoShareを最初にローンチしたとき、ユーザーはファイルを削除してもディスク領域が解放されないと不満を漏らしました。私はPicoShareを固定サイズのディスクボリュームを持つFly VMで運用しているので、ディスクをどれだけ使っても自分には影響ありませんでした。でも定期的なVACUUMを追加するのは簡単だったので、追加したのです。
考え直した結果、PicoShareの挙動を変更して、VACUUMはデフォルトでオフにしつつ、ユーザーがコマンドラインフラグで有効にできるようにすることにしました。
dbPath := flag.String("db", "data/store.db", "path to database")
vacuumDb := flag.Bool("vacuum", false, "vacuum database periodically to reclaim disk space")
flag.Parse()
成功:256MBのRAMで動作するPicoShare
VACUUMをデフォルトで無効にし、他のパフォーマンス修正も適用したことで、PicoShareはついに少ないRAMで安定して動作するようになりました。
Flyのわずか256MBのRAMのVMで、24時間クラッシュなしでPicoShareを動かすことができました。


過去24時間の稼働率は100%
その他の学び
上記で学んだことに加えて、このデバッグの探求の中でいくつか有用な副次的な教訓も得られました。
ビルド・テストのループを最適化する
もっと早くやっておけばよかったと思うことの一つが、ビルド・テストのループの最適化です。仮説を一つテストするための私の手順は次の通りでした。
- 変更をFlyにデプロイする(2〜3分)
- 大きなファイルをアップロードする(1〜2分)
- FlyのRAMメトリクスが追いつくのを待つ(30〜60秒)
つまり、ちょっとした変更をテストするだけで最大6分かかり、各ステップで手作業が必要でした。しかもコード変更にかかる時間は含めていません。
当初はメモリを制限したDockerコンテナでPicoShareを動かしてみましたが、一度もクラッシュしませんでした。
RAM_LIMIT="64m"
PORT=3001
PS_SHARED_SECRET="somesecretpass"

docker run \
  --memory "${RAM_LIMIT}" \
  --env "PORT=${PORT}" \
  --env "PS_SHARED_SECRET=${PS_SHARED_SECRET}" \
  --publish "${PORT}:${PORT}/tcp" \
  --name picoshare \
  mtlynch/picoshare:1.1.7
$ docker stats
CONTAINER ID NAME CPU % MEM USAGE / LIMIT MEM % NET I/O BLOCK I/O PIDS
1ababd398113 picoshare 3.82% 63.68MiB / 64MiB 99.50% 278MB / 208MB 6.09GB / 7.1MB 21なぜPicoShareがDockerと本物のVMで挙動が違うのか、今でもよくわかりませんが、おそらくDockerはVMほど厳密にRAM使用量を制限していないのだろうと推測しています。
Dan WilhelmがPicoShareをローカルで動かしてRAM使用量を観察することでどれだけ進展があったかを報告したとき、変更のたびにFlyにデプロイしてどれだけ時間を無駄にしていたかに気づかされました。自宅のVMサーバーでPicoShareを動かしてみましたが、FlyのときのようにクラッシュもRAMの肥大化も起きませんでした。
最終的にうまくいったのは、Fly上に独自の開発環境を作ることでした。PicoShareのソースと開発ツールを含んだDockerfileを書き、それをFlyにデプロイしました。そこからfly ssh consoleでサーバー上のシェルを開き、コードの変更を素早くテストできるようになりました。
それでもFlyのRAMメトリクスが更新されるまで30秒ほどの遅延があるため、爆速というわけではありませんでしたが、毎回一からデプロイするよりは大幅に改善されました。
説明的なgitブランチとコミットメッセージで記録を残す
この調査中に見つけた有用なテクニックの一つは、各仮説をそれぞれのgitブランチでテストし、結果をコミットメッセージに記録することでした。

あまりにも多くの仮説が飛び交っていたので、どのアイデアをテストしたときにコードがどんな状態だったかを覚えておくのが困難でした。例えば、ある時点ではデバッグ中に自分で導入した新しいバグが原因でクラッシュしていました。
コードがどんな状態にあり、何をテストしたかの記録を残すことで、思考を整理し、同じ作業を繰り返すのを避けることができました。
Goの計測ツールはcgoでのメモリ確保を捉えられない
初期のデバッグステップの一つとして、runtime.ReadMemStatsのRAMメトリクスの一部を表示するページをPicoShareに追加しました(後にnet/http/pprofの方が優れていることに気づきました)。

James Tucker氏が、この計測ではcgo経由で確保したリソースは除外されると指摘してくれました。

私は確かにcgo経由でSQLiteを使っていました。PicoShareはGoで最も人気のあるSQLiteライブラリであるmattn/go-sqlite3を使っています。
そして、cgoを使うとGoが正確なパフォーマンスメトリクスを表示できないのも当然です。外部のCコードを呼び出すためにGoを使っているのであれば、外部コード内のリソースをGoが追跡できないからです。
これを回避するために、SQLiteの純粋なGo実装であるmodernc.org/sqliteを使ってみました。しかし、なぜか純粋なGoのコードでもリソースリークは確認できませんでした。
Flyのディスクは驚くほど高速
あるとき、Twitterのコメンターから、ディスク書き込みでRAMを使い果たしている可能性があると指摘されました。PicoShareがFly VMのディスクに、ディスクが物理メディアにデータを書き込める速度よりも速く書き込んでいたら、データはRAMにキューイングされるだろうというのです。
この説を検証するために、これまで使ったことのなかったfioというディスクベンチマークユーティリティを使いました。使い方が間違っているのかと思いました。クラウドVMとしては信じられないほど速い3353MB/sという書き込み速度が報告されたからです。参考までに、これは自宅のNASサーバーで同じテストを試したときの約30倍の速さです。
Kurt Mackey氏が、FlyのローカルディスクはEnterprise NVMeドライブなので測定値はおそらく正しいと確認してくれました。
行き止まり
私の調査が常に順調に進んだと思いたいところですが、多くの回り道をし、どこにもつながらない仮説を追いかけました。ここではそんな行き止まりのいくつかを紹介します。
Litestreamを疑う
デバッグの第一の鉄則は、問題は自分のコードにあると考えることです。しかし私はここでその原則を破りました。部分的には、これらのバグを追いかけるのにどれだけ手間がかかるかを考えると気が重かったからです。
とはいえ、Litestreamを疑う正当な理由もありました。PicoShareがSQLiteを奇妙な方法で使っているとはいえ、SQLiteに1GBのデータを保存することはそれほど奇妙なことではありません。Litestreamは比較的新しく、SQLiteを斬新な方法で使っているので、クラッシュがLitestreamに起因していると考えてもそれほど突飛なことではありませんでした。
Litestreamを疑ってはいたものの、LitestreamのメンテナーであるBen Johnson氏に余計な仕事を増やしたくはありませんでした。PicoShareはLitestreamにとって特殊なユースケースであり、問題を切り分けるためのシンプルな再現手順も持っていなかったからです。
しかし5月にFlyがLitestreamを買収し、Benをメンテナーとして雇いました。今こそBenに相談する絶好の機会に思えました。LitestreamとFlyの両方に関わることだったからです!
私はLitestreamにバグを報告し、これまでに試したことやLitestreamに関連していると考えた理由を説明しました。そして15分後、Litestreamを無効にした状態でもPicoShareをクラッシュさせることができたので、そのバグはクローズしました。
とはいえ、Litestreamに対してissueを立てたことは有用でした。詳細なバグレポートを書けるほど厳密に問題に取り組むことを強いられたからです。そしてそれがBenの好奇心を刺激し、Litestreamが原因ではないことが明らかになった後も、彼は多くの有用なアドバイスをくれました。
Flyを疑う
ローカルのVMやDockerではクラッシュを再現できなかったとき、問題はFly側にあるのではないかと疑い始めました。私は特に突飛なことをしているわけではないので、他のFlyユーザーが誰もRAM不足でデプロイが落ちることに気づいていないとしたら奇妙だと思ったため、可能性は低いように思えました。
それでも、Flyの可能性を排除しておきたかったのです。そこでPicoShareをAmazonのマネージドDockerコンテナサービスであるLightsailにデプロイしました。そこには256MBのRAMオプションがなかったので、512MBのインスタンスにデプロイしました。数分以内にそこでクラッシュを再現でき、Flyが犯人ではないことを排除できました。
/tmpはRAMディスクではない
Twitterのスレッドでは、何人かのコメンターがFlyが一時ディレクトリをRAMディスクとしてマウントしているのではないかと指摘しました。GoのParseMultipartForm関数はファイルのアップロードを一時ディレクトリに保持するので、もしFlyが一時ディレクトリをRAMディスクとしてマウントしていたら、通常のファイルアップロードでRAMが枯渇する説明がつきます。
しかしlblkを実行しても、/tmpやその他の一時ディレクトリがRAMディスクであることを示す兆候は見当たりませんでした。システムには通常のディスクがあるだけのようでした。
$ lsblk
NAME MAJ:MIN RM SIZE RO TYPE MOUNTPOINTS
vda  254:0    0  128M  0 disk
vdb  254:16   0    8G  0 disk /
$ du -h /tmp/*
149.3M /tmp/multipart-338465586
7.66 /tmp/test1
手作りのmultipartリーダーを書く
Go標準ライブラリのParseMultipartForm関数が、ドキュメント上の制限よりも多くのメモリを消費しているように見えたのは危険信号でした。また、ParseMultipartFormを呼び出してバイトを破棄するだけでもRAMが最大まで使われることにも気づきました。
ParseMultipartFormの問題を回避できるか試すため、自分の特定のシナリオ用に手作りのmultipartリーダーを自作してみました。
残念ながら、自作のmultipartリーダーは標準ライブラリより優れた性能を発揮しませんでしたが、より低いレベルでmultipartデータをいじるのは楽しい経験でした。
アップロードのスロットリング
データをよりゆっくりアップロードすればRAMに何か影響があるか気になりました。Chromeで3G速度をシミュレートしてクライアント側からアップロードをスロットリングしてみましたが、PicoShareの挙動は同じでした。
ディスクへの書き込み速度を落とすためにサーバー側でもスロットリングを試しましたが、こちらも何の効果もありませんでした。
ただ、GoでI/Oをスロットリングするのがいかに簡単かは学べました。io.Readerインターフェースを扱っているのであれば、次のようにReaderをスロットリングされたリーダーでラップするだけです。
import "github.com/juju/ratelimit"

...

throttleRate := 1 << 20 // 1 MB
bucket := ratelimit.NewBucketWithRate(float64(throttleRate), throttleRate)
throttledReader := ratelimit.Reader(reader, bucket)

w := file.NewWriter(tx, metadata.ID, d.chunkSize)
if _, err := io.Copy(w, throttledReader); err != nil {
  return err
}
PicoShare 1.2.0
週末に、この調査で発見したすべてのパフォーマンス問題の修正を含むPicoShareの1.2.0リリースを公開しました。
謝辞
この問題の調査に協力してくれたすべての人に感謝しますが、とりわけ尽力してくれた数名に特別な感謝を述べたいと思います。
コメント
ログインしてコメントする