RustとWebAssemblyで作る、小さな静的全文検索エンジン
原文は Matthias Endler により に公開されました。 このブログを購読する
静的サイトに追加できる、基本的な検索モジュールを作りました。とても軽量で(gzip圧縮で50kB〜100kB)、Hugo、Zola、Jekyllで動作します。完全一致の単語検索のみに対応しています。左側の検索ボックスでデモを試してみてください。コードはGitHubにあります。
静的サイトジェネレーターは魔法のような存在です。パフォーマンスを犠牲にすることなく、動的コンテンツの良いとこ取りを実現してくれます。
このブログも長年にわたり、Jekyll、Cobalt、そして最近はZolaで運営してきました。
ただ、一つずっと気に入らなかったのは、静的サイトなのに「静的」な検索エンジンが付属していないことでした。その代わり、みんなカスタムGoogle検索やAlgoliaのような外部検索エンジン、あるいはlunr.jsやelasticlunrのような純粋なJavaScriptベースのソリューションに頼っています。
どれもほとんどのサイトでは問題なく動きますが、どれも最終的な答えとは思えませんでした。
Googleへの依存をこれ以上増やしたくありませんでしたし、レイテンシが増えプロプライエタリでもあるAlgoliaのようなスタンドアロンのWebバックエンドも使いたくありませんでした。
一方で、JavaScriptに大きく依存したサイトもあまり好きではありません。例えば、lunrが生成する検索インデックスだけでも数メガバイトになることがあります。今日の回線速度を考えても、あまりに贅沢に感じます。さらに、JavaScriptのパースには依然として時間がかかります。
他の静的コンテンツと一緒にデプロイできる、シンプルで軽量、自己完結した検索が欲しかったのです。
結果として、ブログに検索機能を付けること自体を諦めていました。記事が増えるにつれて、関連するコンテンツを見つけるのがどんどん難しくなるのに、残念なことでした。
アイデア
ずっと昔、2013年に「Writing a full-text search engine using Bloom filters」を読みました — それはまさに目から鱗でした。
アイデアはシンプルでした。ブログのすべての記事をジェネレーターに通して、この✨Bloom Filter✨という魔法のようなデータ構造を使った、小さく自己完結した検索インデックスを作ろうというものです。
ちょっと待って、Bloom Filterって何?
Bloom filterは、ある要素が集合に含まれているかを省スペースでチェックする方法です。
ポイントは、要素そのものを保存するのではなく、以前に保存されたことをある程度の確信を持って知ることができる点です。今回のケースでは、ある単語が記事の中にあることを、一定のエラー率で示すことができます。

元の記事から、各投稿のBloom filterを生成するPythonコードを引用します(Stavros Korokithakis氏提供):
filters = {}
for name, words in split_posts.items():
  filters[name] = BloomFilter(capacity=len(words), error_rate=0.1)
  for word in words:
    filters[name].add(word)
無視できる程度の誤検出(false positive)を許容するerror_rateのおかげで、メモリ使用量は極めて小さく抑えられます。
すぐに、自分のホームページにもこんなものが欲しいと思いました。Bloom filterと検索エンジンをそのままブラウザに届けるというアイデアです。これでついに、バックエンドなしで小さく静的な検索を実現できるのです!
頭を抱えた日々
しかし、すぐに幻滅が訪れました。
生成したBloom filterをどうバンドルして最小化すればいいのか、ましてやクライアント側でどう動かせばいいのか、まったく見当がつきませんでした。元の記事ではこの点について簡単に触れられています:
クライアントサイドでBloom filterのアルゴリズムを実装する必要があります。これはおそらく転置インデックスの検索アルゴリズムより少し長くなる程度ですが、それでもおそらく少し複雑になります。
自分のJavaScriptスキルでは、これをやり遂げる自信がありませんでした。2013年当時、NPMは登場からまだ3年、WebPackはできたばかりの1歳で、既存の解決策をどこに探せばいいのかもわかりませんでした。
次に何をすべきかわからず、アイデアは絵に描いた餅のままでした。
新たな希望
5年後の2018年、ウェブはまったく別の場所になっていました。バンドラーは当たり前のものになり、Nodeエコシステムは花開いていました。とりわけ、小さな静的検索エンジンという夢を再び呼び覚ましたものが一つありました。WebAssemblyです。
WebAssembly(略してWasm)は、スタックベースの仮想マシンのためのバイナリ命令フォーマットです。WasmはC/C++/Rustのような高水準言語のコンパイル先として設計されたポータブルなターゲットで、クライアントおよびサーバーアプリケーション向けにウェブ上でのデプロイを可能にします。[出典]
これは、慣れ親しんだ言語を使ってクライアントサイドのコードを書けることを意味していました — Rustです!🎉
私の旅は2018年1月のプロトタイプから始まりました。上で紹介したPython版をそのまま移植しただけのものでした:
let mut filters = HashMap::new();
for (name, words) in articles {
  let mut filter = BloomFilter::with_rate(0.1, words.len() as u32);
  for word in words {
    filter.insert(&word);
  }
  filters.insert(name, filter);
}
各記事のBloom filterを作ることには成功したものの、ウェブ向けにどうパッケージ化すればいいのかは相変わらずわかりませんでした……2018年2月にwasm-packが登場するまでは。
おっと、Rustのコードをあなたのブラウザにお届けしちゃいました
これでパズルのピースがすべて揃いました:
- Rust — 使い慣れた言語
- wasm-pack — WebAssemblyモジュール用のバンドラー
- 概念実証として機能する、動くプロトタイプ
このページの左側に見える検索ボックスがその成果です。WebAssemblyを使って完全にRustで動いています(いわゆるRAWスタックです)。よければ今すぐ試してみてください。
その過程では、かなりの障害がありました。
Bloom Filterクレート
Bloom filterを実装しているいくつかのRustライブラリ(クレート)を調べてみました。
まずjedisct1氏のrust-bloom-filterを試しましたが、型がSerialize/Deserializeを実装していませんでした。つまり、生成したBloom filterをバイナリ内に保存してクライアント側で読み込むことができなかったのです。
他のいくつかを試した後、シリアライズに対応したcuckoofilterクレートを見つけました。動作はBloom filterと似ていますが、違いに興味があればこちらの概要をご覧ください。
使い方は次のとおりです:
let mut cf = cuckoofilter::new();

// Add data to the filter
let value: &str = "hello world";
let success = cf.add(value)?;

// Lookup if data was added before
let success = cf.contains(value);
// success ==> true
cuckoo filterを使って、ブログの10記事分のフィルタをバンドルしたときの出力サイズを確認してみましょう:
~/C/p/tinysearch ❯❯❯ l storage
Permissions Size User    Date Modified Name
.rw-r--r-- 44k mendler 24 Mar 15:42 storage44kBは悪くないように聞こえますが、これは10記事分のcuckoo filterだけをRustバイナリとしてシリアライズしたサイズです。さらに検索機能やヘルパーコードを追加する必要があります。素のwasm-packを使った場合、クライアントサイドのコード全体で216kBにもなってしまいました。多すぎます。
バイナリサイズの削減
最初のプロトタイプで216kBという厳しい結果が出た後、バイナリサイズを小さくするための選択肢がいくつかありました。
一つ目は、johnthagen氏によるRustバイナリサイズの最小化に関するアドバイスに従うことです。
Cargo.tomlでいくつかのオプションを設定することで、かなりのバイト数を削減できます:
"opt-level = 'z'" => 249665 bytes
"lto = true"      => 202516 bytes
"opt-level = 's'" => 195950 bytesopt-levelをsに設定することは、速度とサイズをトレードオフすることを意味しますが、ここでは何よりも最小サイズを重視しています。結局のところ、ダウンロードサイズが小さければパフォーマンスも向上します。
次に、.wasmのコードサイズを小さくする代替のRustアロケーター、wee_allocを試すことができます。
これは、最初に少数回の動的にサイズが決まるアロケーションを行い、その後は追加のアロケーションなしに重い処理を行うコード向けに作られています。このシナリオではアロケーターの存在自体は必要ですが、小さなコードサイズのためならアロケーションのパフォーマンスを犠牲にしても構わないという考えです。
まさに私たちが求めていたものです。試してみましょう!
"wee_alloc and nightly" => 187560 bytesさらにバイナリから4%削減できました。
好奇心から、codegen-unitsを1に設定してみました。これはコード生成に単一スレッドのみを使用することを意味します。驚いたことに、これでバイナリサイズがわずかに小さくなりました。
"codegen-units = 1" => 183294 bytesそれから、binaryenというWasmオプティマイザーの存在を知りました。macOSではhomebrewから入手できます:
brew install binaryenこれにはwasm-optというバイナリが付属しており、さらに15%削減できました:
"wasm-opt -Oz" => 154413 bytes次に、DOMへのバインドが不要なのでweb-sysを削除しました:152858バイト。
Wasmバイナリのコードサイズをプロファイルするためのtwiggyというツールがあります。次のような出力が得られました:
twiggy top -n 20 pkg/tinysearch_bg.wasm
 Shallow Bytes │ Shallow % │ Item
─────────────┼───────────┼────────────────────────────────
         79256 ┊    44.37% ┊ data[0]
         13886 ┊     7.77% ┊ "function names" subsection
          7289 ┊     4.08% ┊ data[1]
          6888 ┊     3.86% ┊ core::fmt::float::float_to_decimal_common_shortest::hdd201d50dffd0509
          6080 ┊     3.40% ┊ core::fmt::float::float_to_decimal_common_exact::hcb5f56a54ebe7361
          5972 ┊     3.34% ┊ std::sync::once::Once::call_once::{{closure}}::ha520deb2caa7e231
          5869 ┊     3.29% ┊ search
見たところ、バイナリの最大の部分は記事の生データセクションが占めています。次に多いのは関数ヘッダーと、おそらくデシリアライズに由来するfloatからdecimalへの変換ヘルパー関数です。
最後に、WebAssembly関数の本体を次のようにunreachableで置き換えるwasm-snipを試しましたが、コードサイズは削減されませんでした:
wasm-snip --snip-rust-fmt-code --snip-rust-panicking-code -o pkg/tinysearch_bg_snip.wasm pkg/tinysearch_bg_opt.wasmcuckoo filterのパラメーターを少し調整し、記事からストップワードを除去した結果、121kB(gzip圧縮で51kB)にまで抑えることができました — ウェブ上の平均的な画像サイズが約900kBであることを考えれば、悪くありません。しかも検索機能は、ユーザーが検索フィールドをクリックしたときにのみ読み込まれるのです。
追記
最近、このプロジェクトをcuckoofilterからXOR filterに移行しました。serdeによるシリアライズが標準で備わった素晴らしいxorfプロジェクトを使ったおかげで、多くのカスタムコードを削除できました。
これにより、ペイロードサイズをさらに20〜25%削減できました。現在、自分のブログでは99kB(49kB gzipped)まで小さくなっています。🎉
新バージョンはすでにcrates.ioで公開されているので、ぜひ試してみてください。
フロントエンドとグルーコード
wasm-packは、Wasmとやり取りするためのJavaScriptコードを自動生成してくれます。
検索UIについては、W3SchoolsのJavaScriptとCSSの一部をカスタマイズしました。キーボード操作にも対応しています!ユーザーが検索クエリを入力すると、各記事のcuckoo filterを順に調べて単語の一致を試みます。結果はヒット数によってスコアリングされます。この部分を追加してくれた親愛なる同僚のJorge Luis Betancourt氏に感謝します。
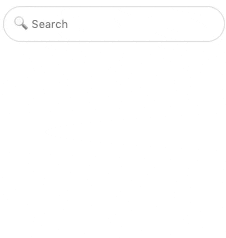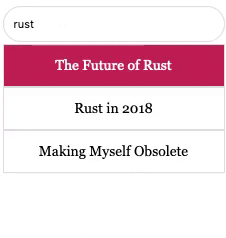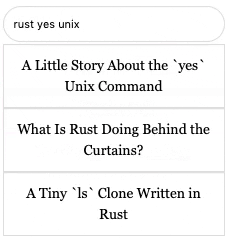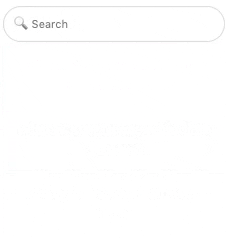
(余談ですが、このアニメーションは非圧縮のWasm検索本体とほぼ同じサイズです。)
注意点
完全一致の単語のみがマッチします。前方一致検索も追加したいのですが、試したところバイナリが大きくなりすぎてしまいました。
使い方
Wasmファイルを生成するスタンドアロンのバイナリはtinysearchという名前です。入力としてJSONファイルへの単一のパスを期待します:
tinysearch path/to/corpus.jsonこのcorpus.jsonには、インデックス化したいテキストが含まれます。フォーマットは非常にシンプルです:
[
  {
    "title": "Article 1",
    "url": "https://example.com/article1",
    "body": "This is the body of article 1."
  },
  {
    "title": "Article 2",
    "url": "https://example.com/article2",
    "body": "This is the body of article 2."
  }
]このJSONファイルは、どの静的サイトジェネレーターでも生成できます。こちらは私のZola用のバージョンです:
{% set section = get_section(path="_index.md") %}

[
  {%- for post in section.pages -%}
    {% if not post.draft %}
      {
        "title": {{ post.title | striptags | json_encode | safe }},
        "url": {{ post.permalink | json_encode | safe }},
        "body": {{ post.content | striptags | json_encode | safe }}
      }
      {% if not loop.last %},{% endif %}
    {% endif %}
  {%- endfor -%}
]Jekyll版もおそらくよく似たものになるはずです。こちらが出発点になります。お使いの静的サイトジェネレーターで動作するものができたら、ぜひ教えてください。
気づいたこと
- ここはまだ西部開拓時代です。不安定な機能、nightly版のRust、ドキュメントはほぼ毎日古くなります。
知恵を絞る覚悟で臨んでください! - 良いアイデアをプロダクトに仕上げるのは大変な作業です。使いやすさ、汎用性、保守性、ドキュメントなど、多くの要素に気を配る必要があります。
- Rustはデッドコードの除去が非常に得意なので、使わないもののためにコストを払うことは通常ありません。それでも、Wasmバイナリに追加する依存関係については非常に慎重になることをお勧めします。不要な機能を追加したくなりますが、それがバイナリサイズを増やしてしまうからです。例えば、テスト中にStructOptを使い、コマンドライン引数をパースする
main()関数を用意していましたが、Wasmには不要だったので後で削除しました。 - 誰もがRustでコードを書きたいわけではないことは理解しています。始めるのは複雑ですが、素晴らしいのは他のほぼどんな言語でも使えることです。例えばGoで書いてWasmにトランスパイルすることもできますし、PHPやHaskellがお好みかもしれません。すでに多くの言語がサポートされています。
- 多くの人がWebAssemblyをおもちゃの技術として片付けていますが、それはまったくの見当違いです。私の意見では、WebAssemblyはウェブやそれを超えた領域でのプロダクト構築のあり方に革命をもたらすでしょう。2年前には非常に難しかったことが、今では簡単になっています。あらゆる言語で書いたコードをすべてのブラウザに届けることです。その未来にとてもワクワクしています。
- 会社のウェブサイト向けにスタンドアロンでセルフホスト可能な検索インデックスをお探しなら、sonicをチェックしてみてください。代替としてstorkもご覧ください。
試してみよう!
以下の制限にご注意ください:
- 完全一致の単語のみを検索します。検索候補は表示されません。前方一致検索は、メントスとダイエットコークのようにバイナリサイズを爆発させてしまうためです。
- すべての記事の検索インデックスを1つの静的バイナリにバンドルするため、小〜中規模のウェブサイトでのみ使用することをお勧めします。1記事あたり約4kB(非圧縮)を想定してください。
現在のコンパイル時間はひどいものです(私の環境ではクリーンインストール後に約1.5分かかります)。主な理由は、インデックスを再構築するたびにRustクレートをゼロからコンパイルしているためです。
追記: これはCephalonRho氏によるPR #13での素晴らしい作業のおかげで、ほぼ修正されました。改めて感謝します!
最終的なWasmコードは、検索サーバーへのラウンドトリップが不要なため、超高速です。即時のフィードバックループは、投稿を検索するというよりリストをフィルタリングするような感覚です。完全にオフラインでも動作するので、アプリにバンドルしたい場合にも便利かもしれません。
コメント
ログインしてコメントする